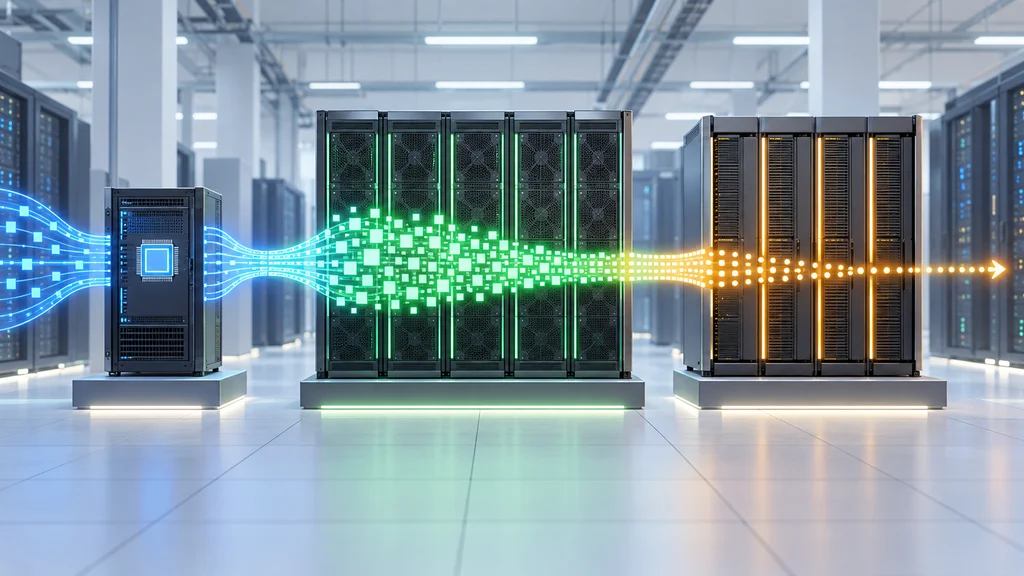
AI推論の処理をCPU、GPU、専用チップへ分けたシステムが、企業向けクラウド上で実動作した。入力を処理するprefillと出力を生成するdecodeを別の演算器に割り当て、データセンターから実演した。
企業向けクラウドに組み込まれた分離型推論
Vista Equity PartnersとCambium Capitalが設立した企業向け推論クラウドのVector Core Computeは、推論の処理を異なる演算器へ分ける構成を公開した。推論要求の制御、prefill、decodeをそれぞれ担当する演算器を定めている。
CPUが制御し、GPUがprefillを処理
実演した構成では、Intel Xeon 6プロセッサーが推論処理の制御と実行を担当した。入力を先に処理するprefillは、NVIDIA Blackwell GPUに割り当てられている。
SN40 RDUによるdecodeとデータセンターからの実演
出力を順次生成するdecodeは、SambaNova SN40 RDUが担当した。Intel、SambaNova、Vista Equity Partners、Cambium Capitalは、この構成の実動作をComputexの会場で披露した。
実演されたシステムは会場内だけで動いていたわけではない。米ロサンゼルスにあるVector Core Computeのデータセンターから稼働していた。
商用顧客のワークロードも稼働
AI開発基盤を提供するTogether.aiは、このエージェント向けクラウドの最初の商用顧客となった。Together.aiのワークロードは、Vector Core Computeのクラウドで稼働している。