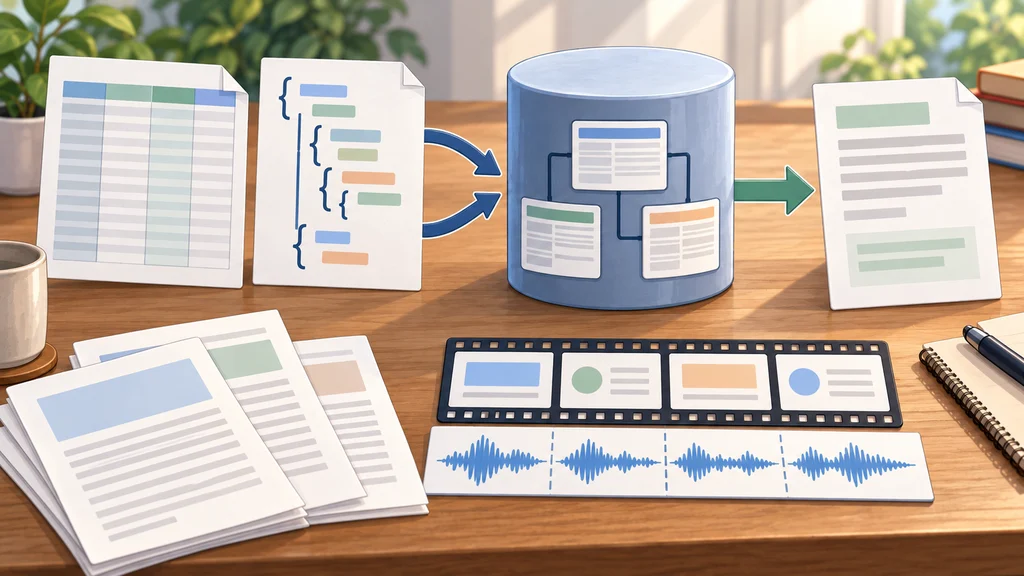
データ分析AIが扱うCSVとJSONを既存のSQLiteへ取り込み、問い合わせを一つのSQL窓口に集約した。小規模LLMの周囲に、変数を保持する実行環境と文書・動画の前処理を組み合わせ、データの確認から回答ファイルの生成までを進める構成だ。
表形式データを集約し、結合の手掛かりを先に渡す
NVIDIAの競技参加チームKGMONは、CSVとJSONを既存のSQLiteデータベース内のテーブルへ変換した。エージェントは形式ごとに別の読み込み経路を選ぶ必要がなくなり、構造化データを一つのSQLインターフェースから調べることができる。
この問い合わせに先立ち、前処理はテーブルや列、結合キーの候補、単位、欠損の傾向、各行が何を表すかを調べる。その情報をタスク開始時に渡すことで、エージェントはデータの構成を受け取った状態で分析に入る。
この構成を使ったKGMONは、KDD Cup 2026 Data Agents競技で2位となった。競技では指定された小規模LLMを使い、異なる種類のデータに対する自然言語の質問から最終回答ファイルを生成することが求められた。
少数のツールで分析を進め、中間結果を保持する
統合したデータを操作する実行環境は、エージェントが使うツールをスキーマ確認、SQL問い合わせ、文書検索、文章からの抽出、回答書き込みに限定した。スキーマを確認するschema()、問い合わせを実行するsql(query)、最終回答を書き込むwrite_answer(df)など、用途を定めた独自の補助関数を用意している。
Python実行環境は、ツールを呼び出すたびに変数を失うことなく、中間結果を次の処理へ引き継ぐ。形式が不正なツール呼び出しはミドルウェアが修復し、一度の呼び出しの誤りで試行全体が終了することを防ぐ。
文書の必要箇所を抽出し、SQL分析へ渡す
文章の取り込みには、表形式データとは別の経路を設けた。Pythonのopen()や.read()によるファイル全文の直接読み込みを禁止し、文字数や正規表現の一致で範囲を絞るプレビュー・検索ツールから必要な箇所を探す。
見つけた箇所は、文書抽出ツールprose_helperが別のLLM呼び出しへ渡す。この呼び出しは温度を0に設定して推論を無効にし、回答や抽出した表を返すため、文書の生の内容を主エージェントのコンテキストへ取り込まずに処理する。
answerモードは規則、しきい値、短い回答を取り出し、tableモードは繰り返し現れるレコードをSQLテーブルへ変換する。抽出した規則をSQL分析の条件として使う経路と、文章中のレコードをテーブルとして扱う経路を用意している。
動画の音声と画面を対応付けてから分析へ入れる
動画もエージェントの分析処理へ入る前に整形した。前処理はキーフレームを抜き出して音声を文字起こしし、文字起こしの各区間を対応するフレームに結び付けたうえで、エージェントへ渡す。
競技の各タスクに含まれる動画は最大1本で、スライド上の制約や誤答へ誘導する値を含むことが多かった。音声の区間と画面を対応付けることで、エージェントは発話の文脈と、それに対応する視覚情報を一緒に参照することができる。