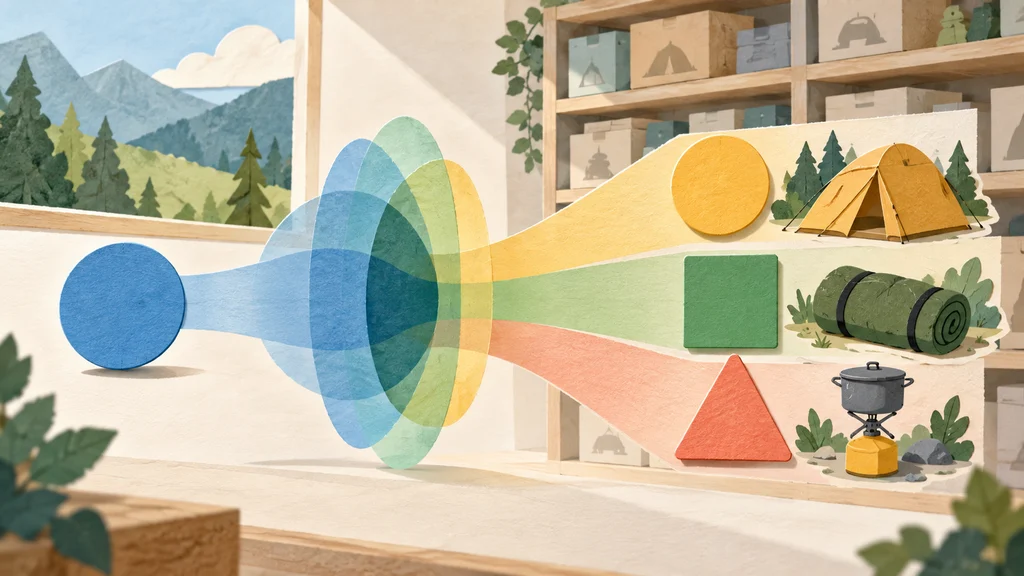
検索要求を複数の検索先へ分解する処理を事前に学習し、推論時には対象の埋め込み集合を1パスで生成する。Googleの検索手法Retrieve-for-Trainは、強化学習で得た振る舞いを小型の拡散モデルへ移し、検索のたびに中間推論のテキストを生成する処理を省く。
検索語の言い換えだけでは結果が重なる
複数の観点を含む検索では、一つの広い要求を関連するサブクエリへ分けるQuery Fan-Outが使われる。たとえばキャンプ用品を探す場合、テントの似た候補だけを並べるよりも、寝袋や調理器具などを含む組み合わせが求められる。
Googleは、汎用のゼロショットLLMにこの分解を任せると、意味の近い検索語を繰り返し生成する問題があるとしている。検索語が増えても扱う観点が重なるため、Retrieve-for-Trainは結果の集合全体を評価する報酬で、サブクエリの生成をオフラインの強化学習によって訓練する。
データベースとの対応と多様性を同時に採点する
自由度の高い検索課題では、複合報酬が三つの条件を重み付きで組み合わせる。データベース内の対象に対応すること、サブクエリの集合が多様であること、元の検索要求から意味が逸れないことを、学習時の評価に組み込む。
データベースとの対応は、生成したサブクエリがデータベースの埋め込み分布から離れるほど減点する。多様性には集合全体を測る指標Vendi Scoreを使い、元の要求との整合性も併せて評価することで、関連性と検索範囲の広さを同じ報酬に反映する。
学習済み言語モデルの出力を教師データにする
強化学習を終えた言語モデルは固定され、検索要求と、それに対応する対象集合の組をオフラインで合成する。この教師データの作成には人手のラベルを必要としない。
合成した組は、次段階の検索モデルへ渡される。Retrieve-for-Trainは5390万パラメーターの拡散モデルをこのデータで訓練し、言語モデルが学んだ検索要求の展開を別のモデルへ移す。
推論時は対象の埋め込み集合を直接出力する
Googleによると、訓練した拡散モデルは検索要求の埋め込みを入力とし、対象の埋め込み集合を非自己回帰の1パスで直接生成する。対象ごとの方向をテキストの検索語として順番に書き出す処理を、集合をまとめて出力する処理へ置き換える。
この出力方式により、検索要求の展開にはテキストの中間推論トークンが不要になったという。検索のたびに言語モデルが分解方針を考える処理は、オフラインでの強化学習と教師データの合成へ移され、推論時には訓練済みの拡散モデルが埋め込み集合を生成する。