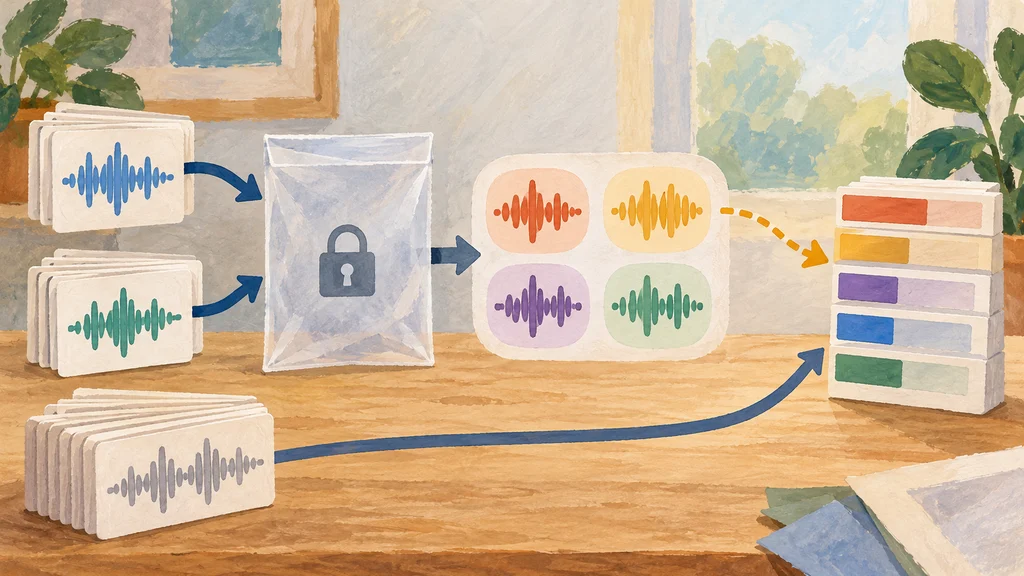
音声認識モデルの比較基盤Open ASR Leaderboardに、非公開の英語音声を使う評価が加わった。朗読と会話、米国と米国以外のアクセントを分けて成績を表示する。総合評価への組み入れは任意とし、公開データだけで計算する既定の順位を維持する。
非公開の朗読・会話データを評価へ組み込む
Hugging Faceが公開した更新では、音声データ提供企業のAppenとDataoceanAIによる英語音声が、Open ASR Leaderboardの評価セットに加わった。複数のアクセントを含み、原稿を読み上げる朗読と、自発的な会話を対象にする。
運営側は、公開テストへの特化や、テストデータが学習に混入するリスクを抑えるため、追加データを非公開に保つ。評価用音声を公開して利用者自身に採点してもらう方式とは、データへのアクセス条件が異なる。
条件別の平均を表示し、個別スコアは伏せる
非公開データの成績は「private data」タブで確認できる。朗読、会話、米国アクセント、米国以外のアクセントの各区分について、該当するデータセットの成績を単純平均して表示する。
この集計に使う個々の分割セットのスコアは表示しない。運営側は、発話形式やアクセントの区分で成績を比較できるようにしながら、特定の提供元やアクセントへの最適化を避ける構成としている。
提供元を等しく重み付けし、総合順位への反映を選べる
非公開データの総合指標「average WER」は、単語誤り率を提供元ごとに平均し、その平均値をさらに単純平均して求める。これにより、提供元ごとの重みを等しくする。
ランキング全体のaverage WERは、既定では引き続き公開データだけで計算する。利用者が非公開データを有効にすると集計対象へ加わり、「Rank Δ」欄で既定の設定から順位がどう変化したかを確認できる。
運営側が非公開データでモデルを評価する
非公開データで評価を受けるには、モデルをランキングへ追加する申請を行う。申請者はGitHubでプルリクエストを作成し、従来どおり公開データでの評価結果を報告する。
運営側は公開データの結果を確認したうえで、非公開データの指標を計算する。得られた結果を申請者が確認する手順により、評価データを公開せずにモデルの成績をランキングへ登録する。