AI
MoE学習レシピ、8基のB200でHugging Face実装の最大2.21倍の処理量
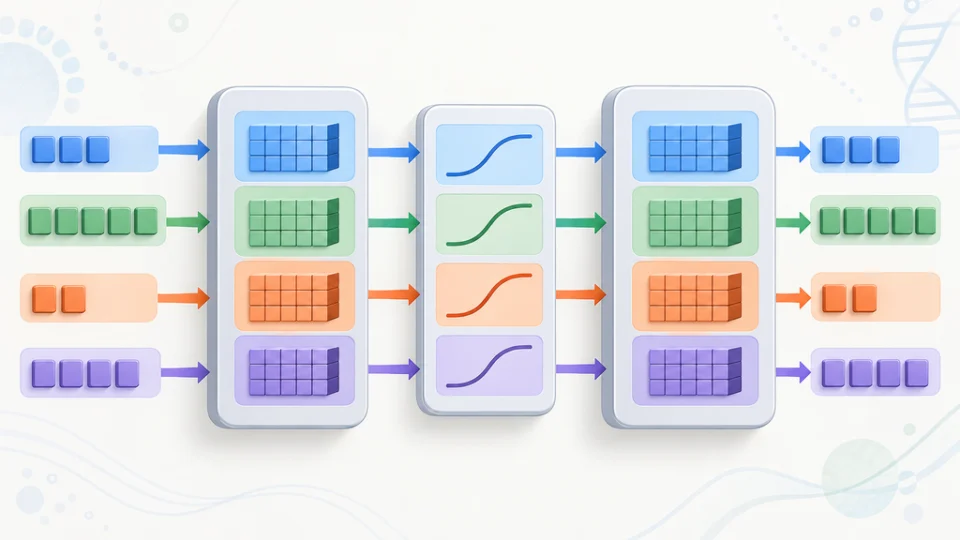
MoEモデルの学習で、Expertごとに分かれていた演算をまとめ、低精度計算と演算融合につなぐレシピが示された。NVIDIAの8基のB200によ…
TOPIC
MoEモデルの学習で、Expertごとに分かれていた演算をまとめ、低精度計算と演算融合につなぐレシピが示された。NVIDIAの8基のB200によ…
異なるAIコーディングエージェントの過去セッションを一つの索引へまとめ、判断や理由を次の作業へ引き継ぐ共有メモリ「funes」が公開された。意味…
音声認識モデルの比較基盤Open ASR Leaderboardに、非公開の英語音声を使う評価が加わった。朗読と会話、米国と米国以外のアクセント…
小型モデルに続きの文章を先読みさせ、大きなモデルがまとめて検証する生成方式「Assisted Generation」が利用できるようになった。候…
コード生成モデルに対話データを追加学習させ、プログラミングの質問に応答するStarChatが公開された。長い対話例を毎回入力する方法に加え、モデ…
回答への投票と質問者による採用情報を使い、言語モデルを質問応答向けに調整したStackLLaMAが公開された。回答の比較に使う評価点を既存の投稿…
200億パラメーターの言語モデルの強化学習を、メモリー24GBのGPUで実行できるようになった。8ビット化と小規模アダプターの学習に加え、学習用…