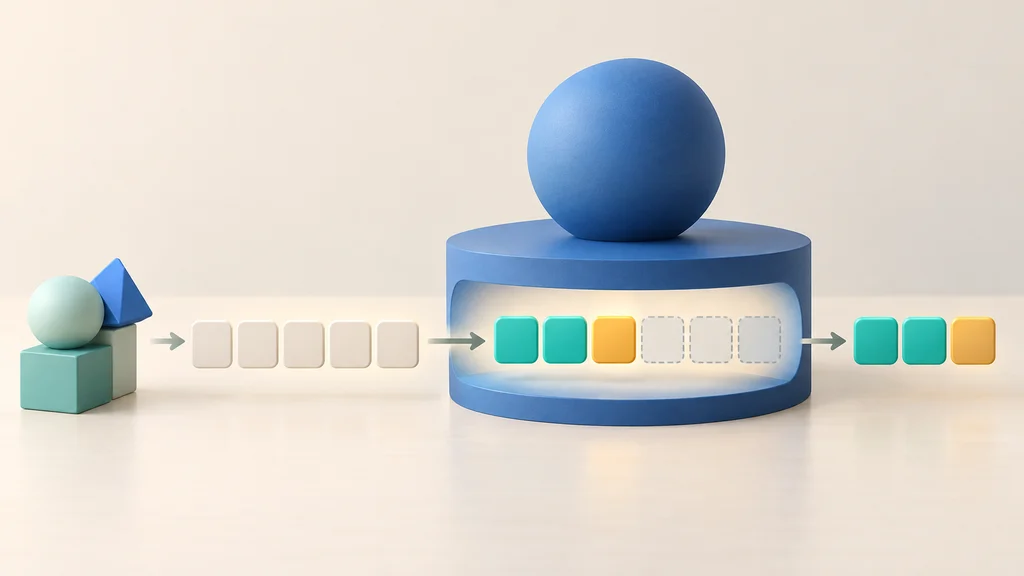
小型モデルに続きの文章を先読みさせ、大きなモデルがまとめて検証する生成方式「Assisted Generation」が利用できるようになった。候補が連続して一致する区間では、大きなモデルを1トークンごとに実行する回数を減らす。
重みの読み出しを候補列の検証に生かす
文章生成の高速化方式であるAssisted Generationは、小型の補助モデルが生成した候補列を、対象モデルの一度の順伝播で検証する。Hugging Faceが公開した実装は、この候補生成と検証を繰り返して文章を延ばす。
Hugging Faceは、大規模モデルの順伝播では重みをメモリーから演算部へ読み込む帯域がボトルネックになると説明している。候補列をまとめて検証する処理は、重みを読み出した一度の実行から、複数トークンの採否を決めるために使う。
最初の不一致までを採用する
対象モデルは、入力列の各位置について、それより後のトークンを参照せずに次トークンの予測値を計算できる。この性質を使えば、候補列を一括して入力しても、各候補がそれまでの文脈に沿うかを調べられる。
検証では候補を先頭から照合し、一致した部分を残す。最初に不一致となった位置では対象モデルが選んだトークンを採用し、それより後の候補は破棄して、確定した列から生成を続ける。
一致率に合わせて先読みの長さを調整する
補助モデルにも候補を生成する時間がかかるため、初期実装は先読みの長さを固定しない。候補数を5から始め、すべて一致すれば次回は2増やし、不一致があれば1減らす。
補助モデルと対象モデルには、同じトークナイザーを使う必要がある。トークンの区切り方を共通にすることで、候補をいったん文字列へ戻し、対象モデル向けに再符号化する処理を避ける。
GPUメモリーへの収まり方で速度向上が変わる
Hugging Faceのバッチサイズ1の貪欲デコード測定では、モデルがGPUメモリーに収まる場合、INT8使用時に最大3倍、それ以外で最大2倍の高速化を得た。モデルが収まらずメモリーオフロードを使う条件では、最大10倍の高速化を得たとしている。
モデル実行ライブラリのtransformersでは、generate()のassistant_model引数に補助モデルを渡して利用する。公開時の対応範囲はバッチサイズ1である。