AI
LLMの先読み生成、GPUの処理特性から候補トークン数を決める指針
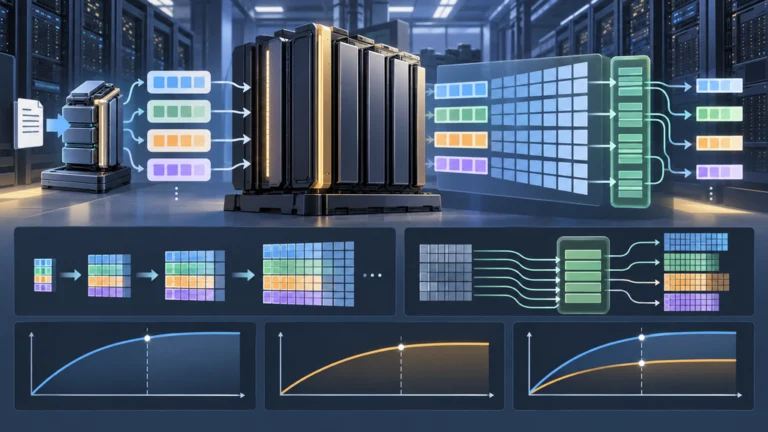
LLMの投機的デコードで先読みするトークン数について、NVIDIAはGPU上の行列演算とAttentionの処理特性に基づく選定指針を示した。候…
TOPIC
LLMの投機的デコードで先読みするトークン数について、NVIDIAはGPU上の行列演算とAttentionの処理特性に基づく選定指針を示した。候…
Jetson上の推論モデルにNVFP4量子化と投機的デコーディングを重ね、処理負荷と検証回数を同時に減らす構成が示された。NVIDIAの測定では…
対応する公開AIモデルのチェックポイントから実行用バンドルを作り、C++アプリケーションでTensorRT推論を動かす経路が用意された。構築には…
履歴を固定サイズへ圧縮し、必要な領域だけをブロック単位で参照する長文AIモデルが登場した。100万トークン条件の公開ベンチマークでは、Atten…
LLM推論エンジンの障害に備え、GPU上のモデル重みを共有する待機エンジンが事前に初期化される。NVIDIAの2ワーカー構成での測定では、1基の…
AIエージェントの作業記録を再生する評価で、推論基盤Vera Rubin NVL72がGB300 NVL72の最大30倍のメガワット当たり処理量…
ロボット制御用に追加学習した40億パラメータのAIモデルが、Jetson AGX Thor上で約2.13秒分の動作指令を約1.53秒で生成した。…
推論中の成功と失敗をスキルや洞察として抽出し、後続タスクで使える知識へ更新するテスト時学習が開発された。EvoLibは正解ラベルやモデル更新を使…