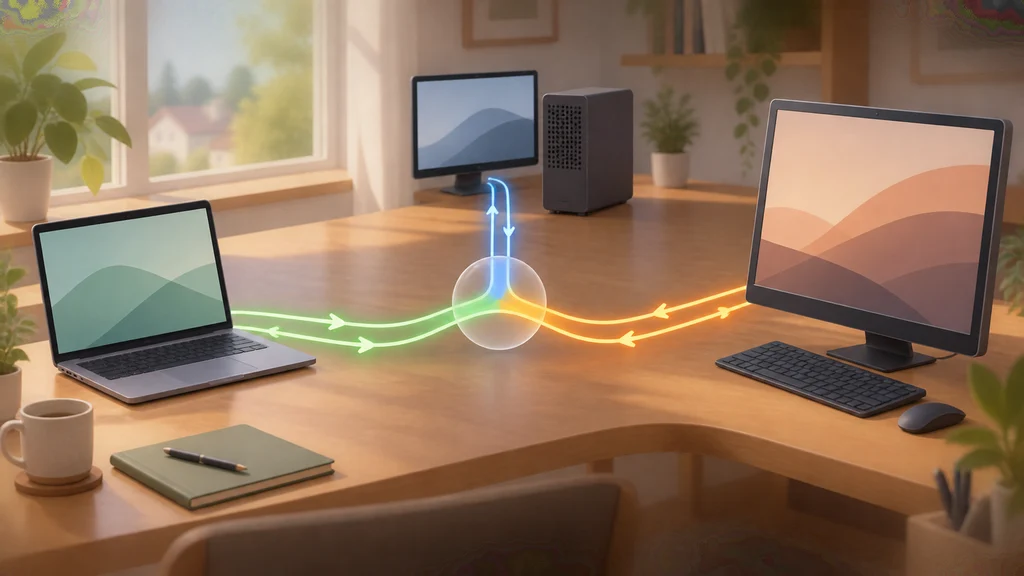
独立したAI推論要求を家庭内の複数端末へ振り分けるルーター「PAIR」をNVIDIAが公開した。既存のローカル推論インターフェースを使い、各要求を条件に合う一台へ割り当てる。5つのサブエージェントを使う実演では、3端末構成の平均完了時間が単独端末より短かった。
既存の推論接続を複数端末へ広げる
NVIDIAの仮想推論ルーターNVIDIA Personal AI Router(PAIR)は、家庭内ネットワークにある対応端末へ独立したAI推論要求を振り分ける。複数のエージェントが同時にモデルを呼び出す場合、要求ごとに実行先を選べる。
PAIRはローカル推論サービスのOllamaとLM Studioが使う互換インターフェースを代理する。エージェント側の実行基盤を変更せず、既存の接続先を通じて推論要求を送れる。
要求ごとに一台を選び、応答を元の接続へ戻す
要求を受けたPAIRのプロキシは、必要な推論エンジンとモデルを識別し、条件を満たす端末を一つ選ぶ。選ばれた端末で推論が始まり、その要求は完了まで同じ端末で処理される。
生成された応答はPAIRを経由して元のアプリケーションへ返る。複数端末に分散する単位は独立した要求であり、一つの要求を複数端末に分割する方式ではない。
端末の状態とモデルの有無で配置先を更新する
PAIRはmDNSを使い、ローカルネットワーク上の参加端末を発見する。対応端末は利用可能なときに処理対象へ加わり、スリープや電源停止などで利用できなくなれば外れる。
新しい要求の配置では、端末の稼働状態に加え、推論エンジンと要求されたモデルの有無を確認する。実行中の作業やGPU使用状況も考慮するため、参加端末が常に同じ状態である必要はない。
5つのサブエージェントによる作業を3端末で実演
NVIDIAの実演では、エージェントアプリケーションのHermes Desktopが五つのサブエージェントによる作業を構成し、Ollamaが各端末でモデルの推論を実行した。PAIRはその間に入って、独立した推論要求の実行先を選んだ。
同じ作業の平均完了時間は、RTX Spark搭載ノートPC単独で18分だった。ノートPC、DGX Spark、RTX 5090搭載端末を組み合わせた3端末構成では8分48秒となった。この数値はNVIDIAによる特定構成での実演結果である。