AI
B200でLLMを機密計算、出力トークン処理量は非機密構成の96.1~98.2%
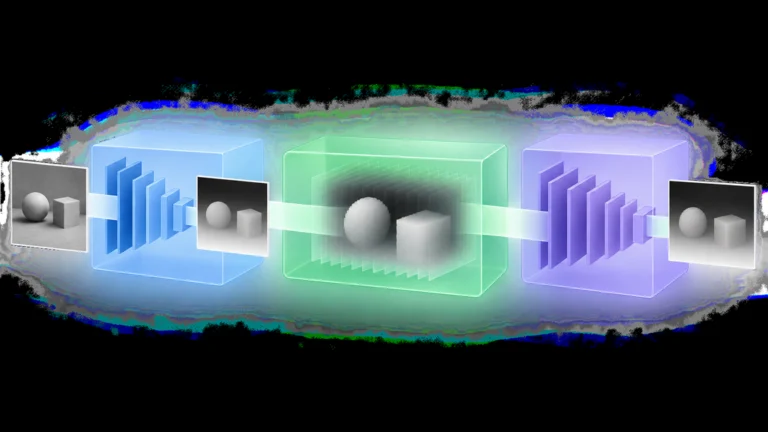
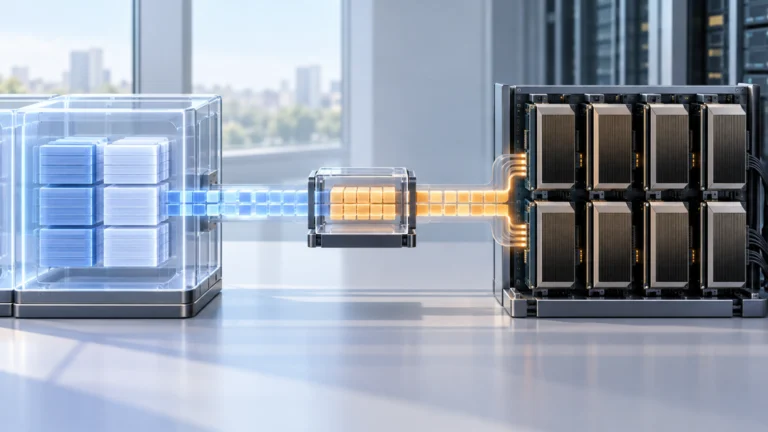
B200の機密計算下で、LLM推論のデータ転送とカーネル計測を保護された実行経路に合わせた。NVIDIAが8基のB200で測定した出力トークン処…
TOPIC
B200の機密計算下で、LLM推論のデータ転送とカーネル計測を保護された実行経路に合わせた。NVIDIAが8基のB200で測定した出力トークン処…
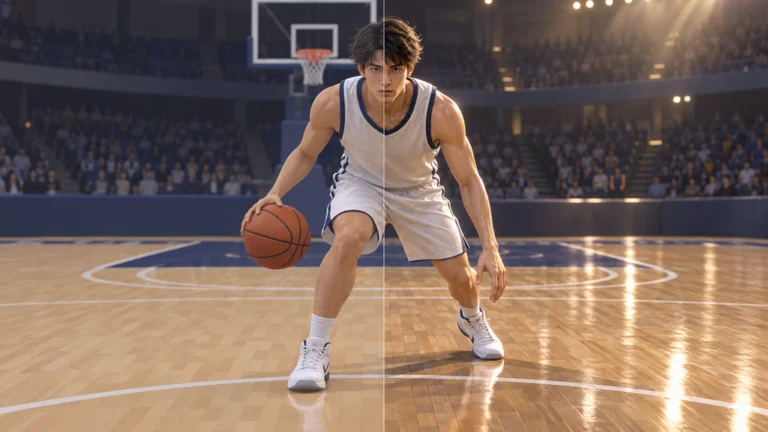
ゲームエンジンが描いた画像を基礎に、光と素材の細部をAIで加える処理がDLSS 5に組み込まれた。NVIDIAは、元の場面構造や人物の同一性を保…
GPUで画像を処理するROS 2ノードが、標準メッセージを保ちながらGPU上のデータを次のノードへ渡せるようになった。NVIDIAが提供したCU…
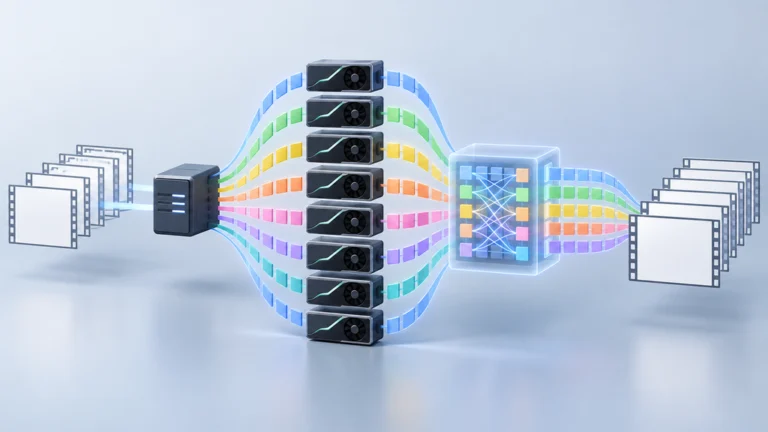
動画生成AIの重いTransformer処理を、1つの推論窓口から複数GPUへ分散できるようになった。NVIDIAの測定では、動画1件の生成時間…
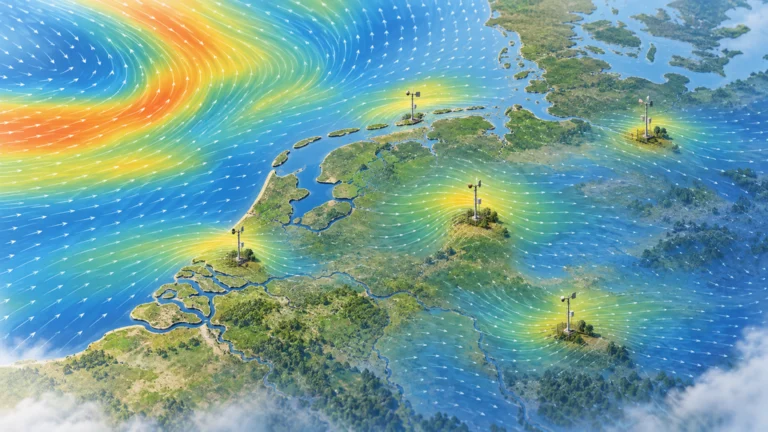
拡散型の気象AIが予測を生成する途中へ地上観測を加える手法で、再学習なしに出力を補正できる。NVIDIAが示した欧州の風速推定例では、同化に使わ…
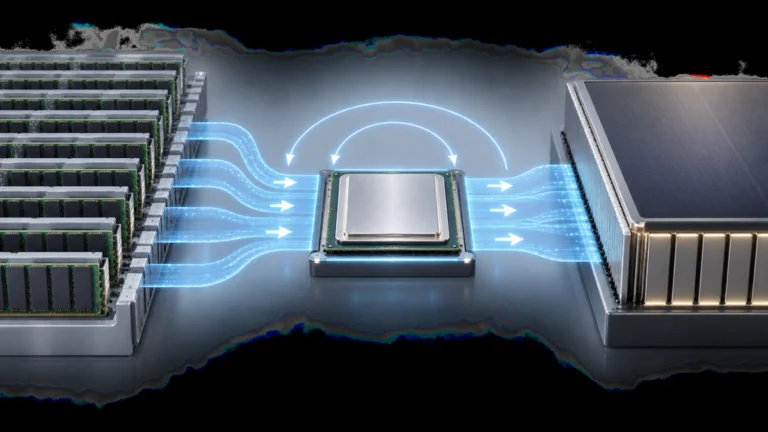
NVIDIAのAIシステム「DGX Rubin NVL8」は、Intel Xeon 6をホストCPUとして採用する。CPUがタスクの調整やメモリ…
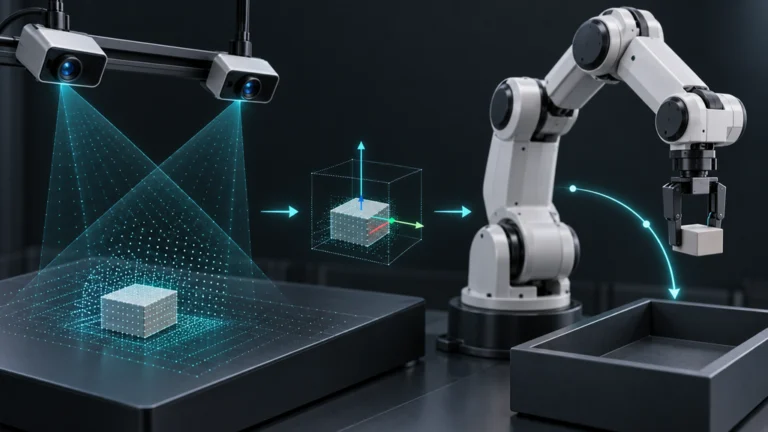
GPUアクセラレーション対応のロボット開発パッケージIsaac ROS 5.0は、セットアップ、知覚モデルの調整、ピックアンドプレースをAIエー…
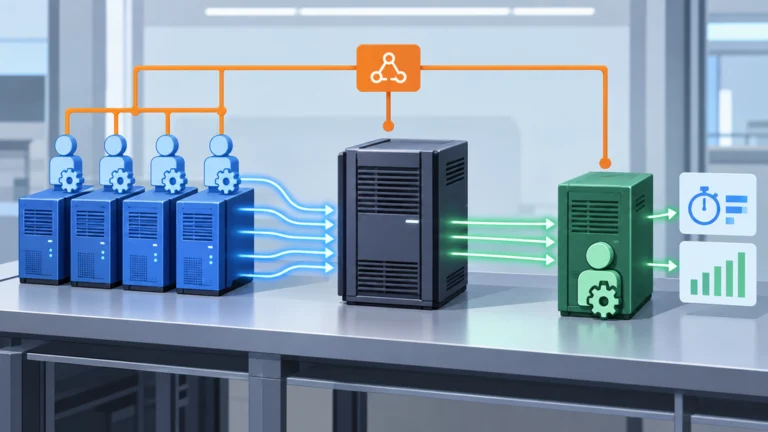
LLM推論の負荷試験ツールAIPerfは、要求の送信と結果の処理を複数プロセスへ分ける構成になった。NVIDIAは、測定クライアント側が高い同時…