AI
DeepSeek-V3学習のGPU演算性能、最適化前の10.4倍に
Expertごとに届くトークン数が変わるMoEモデルの学習を、JAX向けのGrouped GEMMなどで高速化した。NVIDIAのDeepSee…
TOPIC
Expertごとに届くトークン数が変わるMoEモデルの学習を、JAX向けのGrouped GEMMなどで高速化した。NVIDIAのDeepSee…
生体分子の構造予測で、モデル内部のGPU演算と多数の入力を流す処理経路を高速化する推論基盤が登場した。NVIDIAの比較では、タンパク質二量体1…
AIモデルの推論で、利用者ごとの応答速度を保ちながらシステム全体の出力を増やす構成が示された。NVIDIAの測定では、Nemotron 3 Ul…
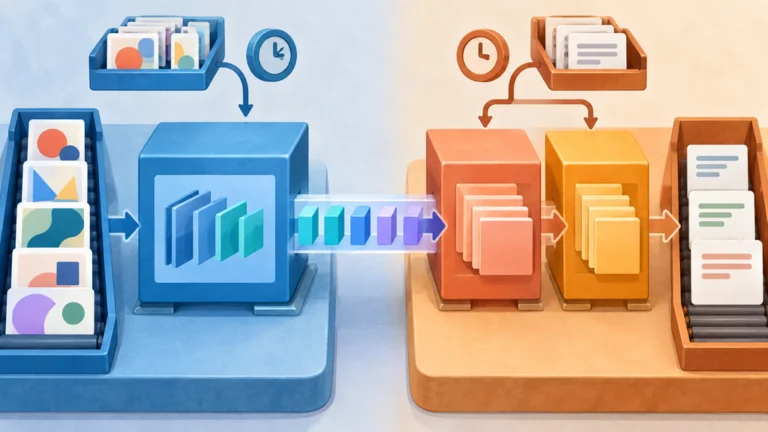
画像を扱うAI推論で、視覚エンコードを言語モデルの処理から分離する構成が実装された。NVIDIAの測定では、画像の多い入力など適した条件で、初回…
製造拠点への部材配分を支援するAIが、担当者の判断理由と生産結果を使って追加学習された。NVIDIAの開発時評価では、配分判断の正答率が基礎モデ…
ロボタクシー開発を、AI学習、合成環境での検証、車載処理の3つの計算基盤でつなぐ構成が商用規模の開発へ広がっている。NVIDIAは、実走行の希少…
CUDA Toolkit 13.4は、Arm向けCUDAアプリケーション開発をWindowsへ拡張した。共有GPUの分割制御や、NVLink f…
ツール利用やコード実行などを支えるエージェント型AI向けCPUが出荷段階に入った。NVIDIAのVera CPUは、GPUや推論アクセラレーター…