AI
LLMの先読み生成、GPUの処理特性から候補トークン数を決める指針
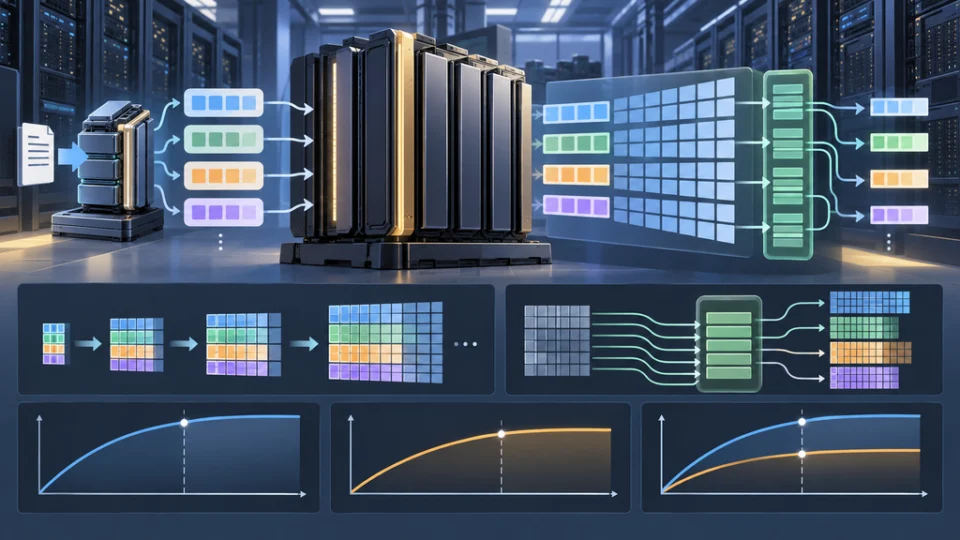
LLMの投機的デコードで先読みするトークン数について、NVIDIAはGPU上の行列演算とAttentionの処理特性に基づく選定指針を示した。候…
TOPIC
LLMの投機的デコードで先読みするトークン数について、NVIDIAはGPU上の行列演算とAttentionの処理特性に基づく選定指針を示した。候…
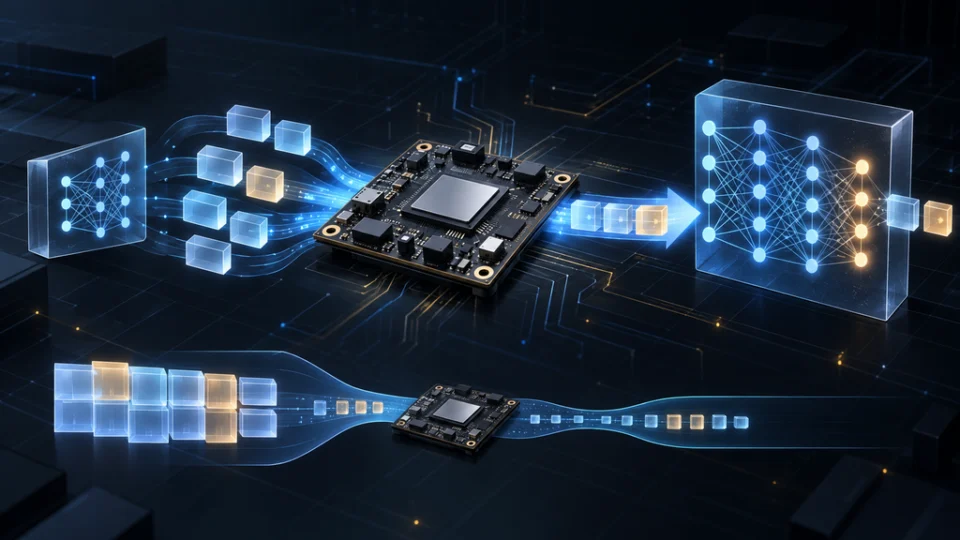
Jetson上の推論モデルにNVFP4量子化と投機的デコーディングを重ね、処理負荷と検証回数を同時に減らす構成が示された。NVIDIAの測定では…
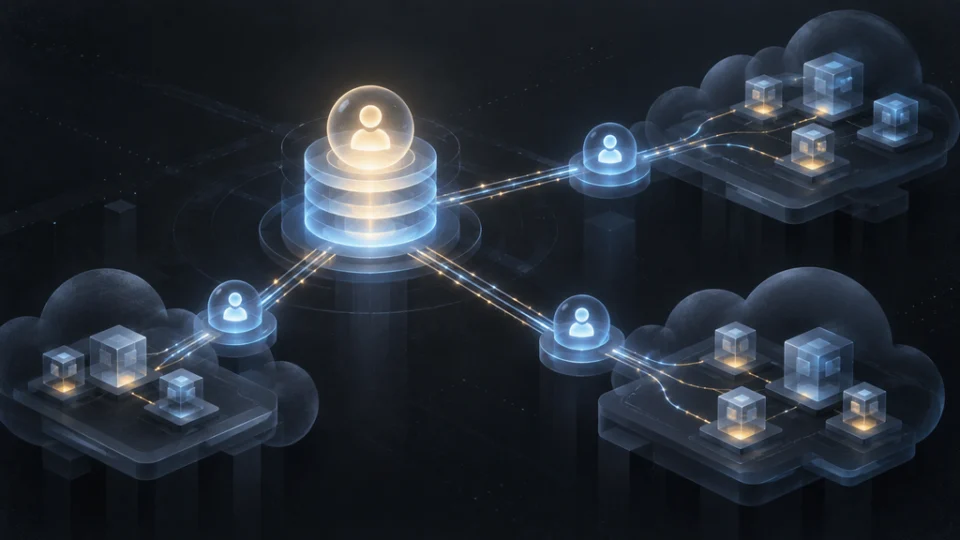
中央で保持する共通セッションを地域ゲートウェイが検証し、分散した実行環境へ信頼済みのユーザー情報を渡す。NVIDIAによると、この構成を採用した…
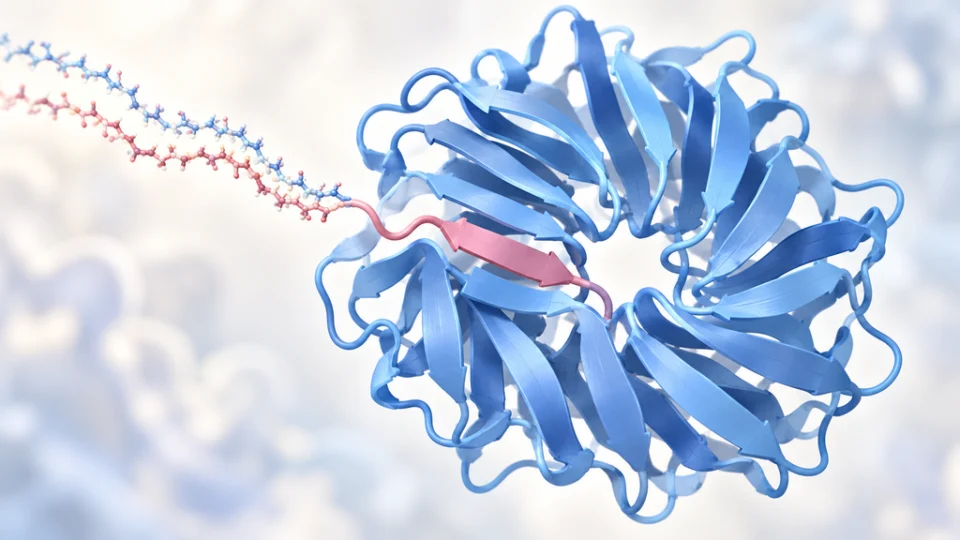
タンパク質の配列照合から複合体の構造予測までを、AIエージェントが専門サービスを呼び出して進めた。NVIDIAとAnthropicが連携した実行…
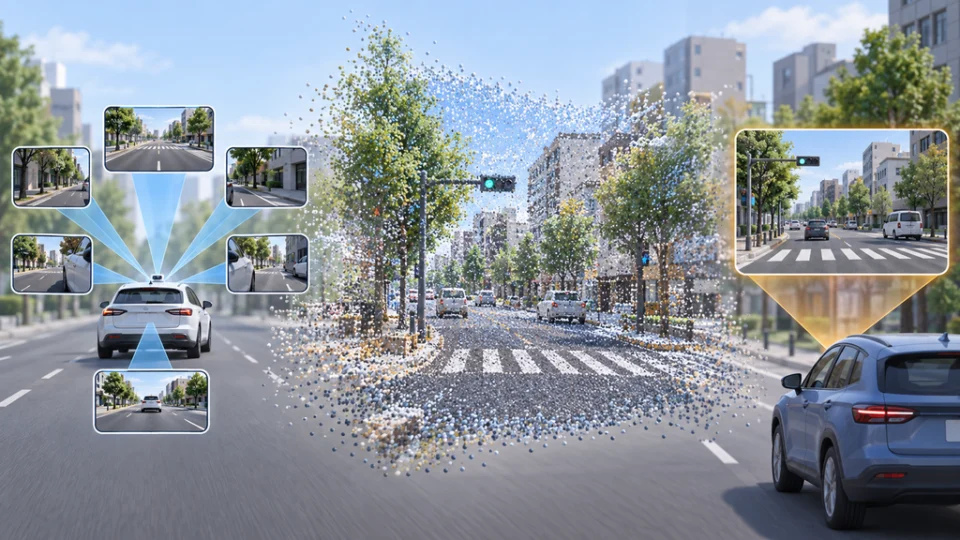
実走行を再構成した3Dシーンから、別車種のカメラ配置に合わせた映像を生成し、自動運転の認識モデルの学習に使う手順が示された。車種ごとに異なるカメ…
対応する公開AIモデルのチェックポイントから実行用バンドルを作り、C++アプリケーションでTensorRT推論を動かす経路が用意された。構築には…
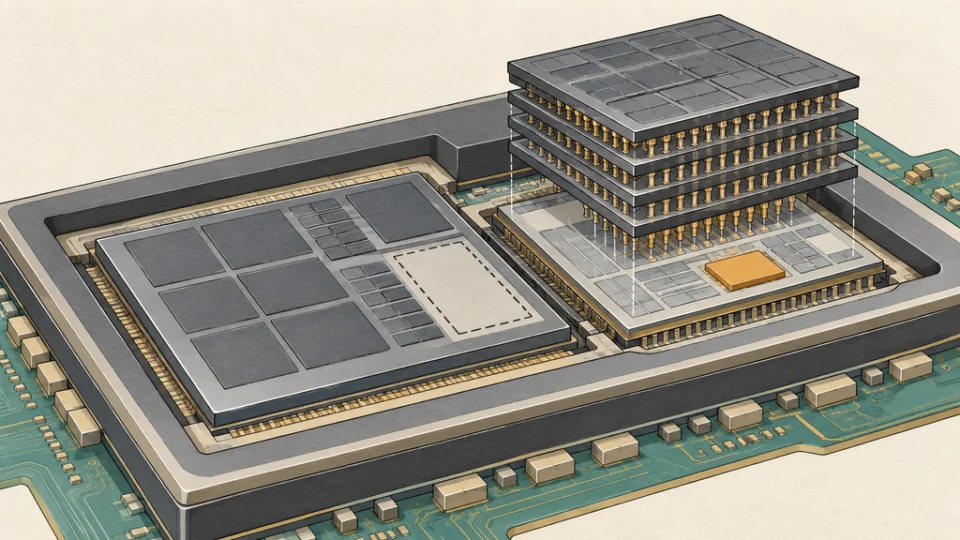
高帯域メモリー技術NVHBMは、演算チップ上に置いていたメモリー制御回路を積層メモリー側へ移す。NVIDIAは、標準HBM4Eより帯域を増やし、…
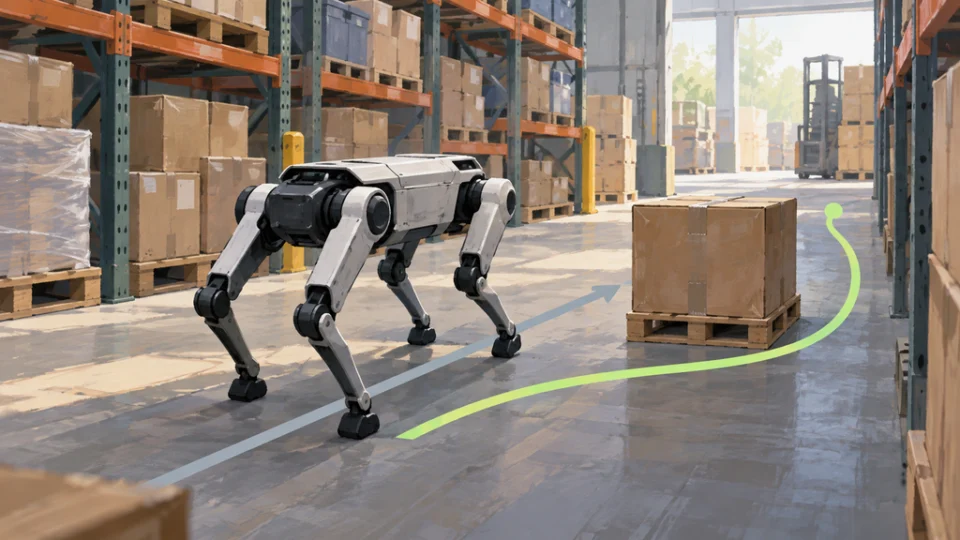
ロボット航法を別の機体や環境に移すため、既存の方策に行動の補正を学習させるCOMPASSの開発手順が示された。AIエージェントがシーン準備から評…