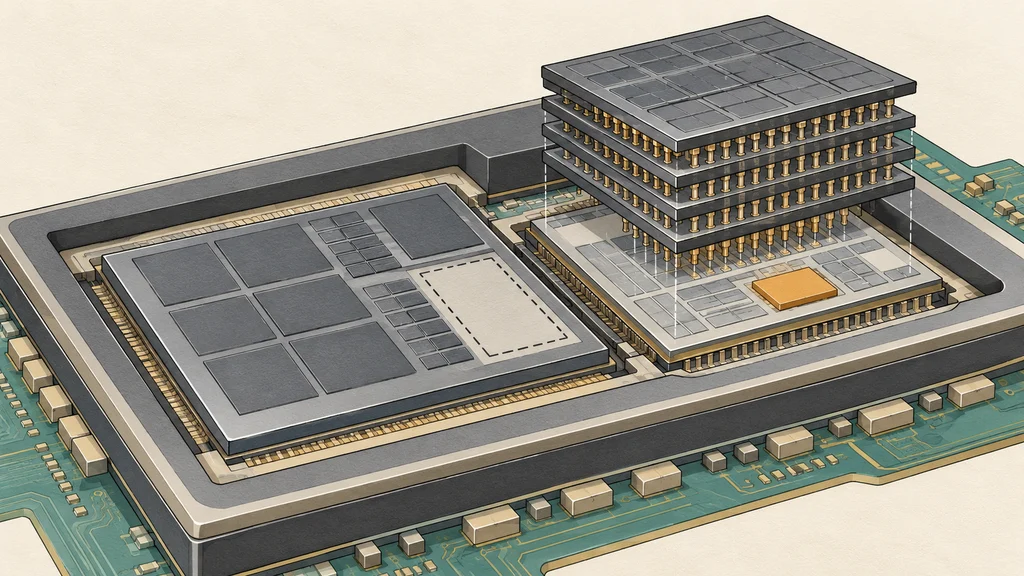
高帯域メモリー技術NVHBMは、演算チップ上に置いていたメモリー制御回路を積層メモリー側へ移す。NVIDIAは、標準HBM4Eより帯域を増やし、HBM消費電力を減らしながら、演算ダイ上の面積を解放するとしている。
制御回路をHBMのベースダイへ統合
NVIDIAは、独自の演算チップをラック規模の基盤へ組み込むNVLink Fusionに、高帯域メモリー技術NVHBMを追加した。メモリーパートナーが検証と提供を担う予定で、今回の追加は技術の採用方針を示す段階にある。
従来のHBM構成では、メモリーへのアクセスを制御するメモリーコントローラーが、演算チップであるXPUのダイ上に置かれる。NVHBMはこの制御回路を、積層メモリーを構成するHBMのベースダイへ統合し、制御回路の配置先をメモリー側へ移す。
帯域と消費電力、演算ダイ面積を同時に変える
NVIDIAは、この配置変更により、NVHBMのメモリー帯域が標準HBM4Eより最大30%増えるとしている。同じ比較でHBM消費電力は15%低くなるという。消費電力の削減対象はHBMであり、システム全体の電力削減率を示す数字ではない。
制御回路の移動は、XPU側の面積配分にも作用する。NVIDIAは、標準HBM4Eを使う構成と比べ、XPUの演算ダイ上で最大25%分の面積を解放するとしている。この数字は演算ダイ側で空く面積を表し、演算性能の向上率を示すものではない。
複数の供給元で共通の実装を用意
NVIDIAは、複数のメモリー供給企業から提供される標準的なNVHBM実装を整備している。共通の実装を使うことで、供給元が異なるメモリーを独自AIチップへ組み込み、その適格性を確認する開発作業を減らすとしている。
独自チップのラック接続とメモリー採用をつなぐ
NVLink Fusionは、独自のXPUやCPUをNVIDIAのラック規模のプラットフォームへ接続する仕組みである。この接続基盤に加わるNVHBMについて、Amazonの半導体開発部門Annapurna Labsが最初の協業パートナーとなり、NVLinkのスケールアップ構成もNVIDIAと共同で扱う予定だ。
ラック接続への対応は、AmazonのAI向け演算チップにも組み込まれる予定である。Annapurna Labsは、次世代TrainiumチップのTrainium4からNVLink Fusionに対応する計画を示している。