映像解析AIの参照構成VSS 3.3に、必要な機能を組み合わせて配置するスキルと、映像の変化に応じて入力を減らす処理が加わった。構築時には共有サービスの重複を抑え、実行時には変化のない領域を繰り返し処理する量を減らす。
四つの検証済み構成から必要な機能を組み立てる
NVIDIAが開発する映像解析AIの参照構成VSS 3.3は、構築用のBuild Vision Agentスキルによって、警告、検索、要約などを一つのアプリケーションへ組み合わせる。開発者が目的を自然言語で指定すると、スキルが必要なマイクロサービス、設定、実行時の操作を含む配置計画へ変換する。
計画の出発点には、検証済みの四つの開発者向けプロファイルを使う。映像クリップの説明生成と質疑応答、警告、長時間映像の要約、検索から要求に近い基礎構成を選び、必要な変更だけを加える。
検出器とデータ基盤を共有して配置する
選んだ基礎構成へ機能を加える際、構築スキルは要求された機能が使うサービスだけを残す。二つの機能が検出器を必要とする場合は一つを共有し、KafkaとElasticsearchを使う場合も共通の配置へまとめ、機能ごとに別のインデックスへ書き込む。
配置前には構成図を提示し、確認を経て検証、配置、準備状態の確認を行う。稼働中の構成に機能を追加する際も既存サービスを再利用し、差分によって拡張するため、警告や検索の機能ごとに基盤を作り直す手間を抑える。
変化のない映像領域をVLMの入力から削減する
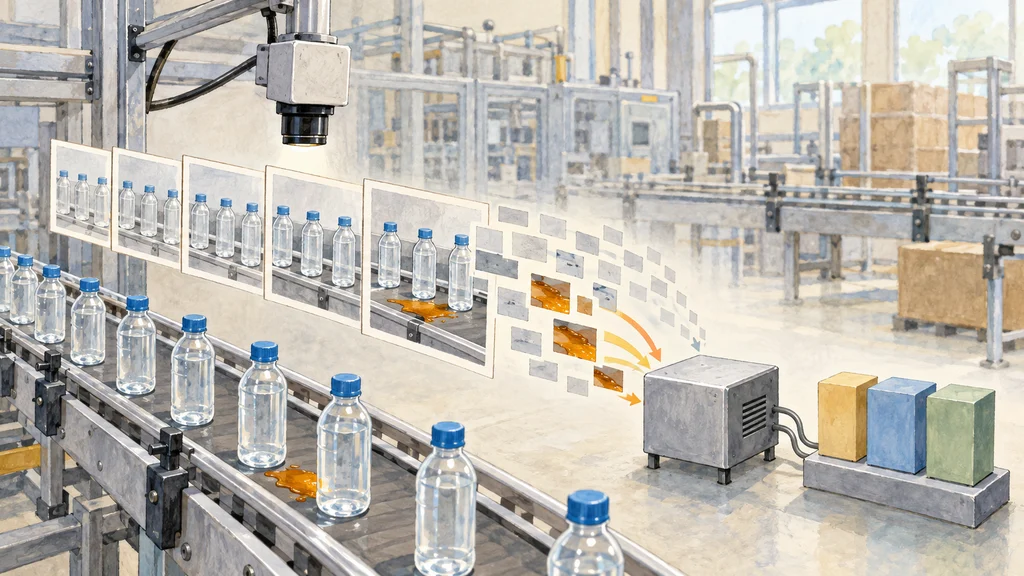
配置したアプリケーションが映像を処理する段階では、入力削減機能のAdaptive Efficient Video Sampling(Adaptive EVS)が働く。視覚言語モデル(VLM)へ渡す視覚トークンのうち、前のフレームから変化していない領域を削減し、出来事が起きる場面に合わせて処理をまとめる。
従来のEVSは固定の削減率を使っていた。今回リアルタイムVLMマイクロサービスへ統合された適応型の処理は、画像を区切ったパッチごと、フレームごとに保持するトークンを決め、変化のない映像に費やす処理量を抑える。
60分の要約で入力トークンを80%削減
NVIDIAの測定では、Adaptive EVSによって60分の映像を要約する際のVLM入力トークンが80%減少した。同じGPUで処理する同時ストリーム数も46%増加しており、入力削減の効果が要約と複数映像の並行処理に表れている。
構築側では、瓶詰めラインを対象にしたデモで、一つのプロンプトから30分未満で映像解析AIを構築・配置した。配置したエージェントは液体の流出に対する警告を発生させ、VLMで検証した。この流出はデモ用に合成したものだった。