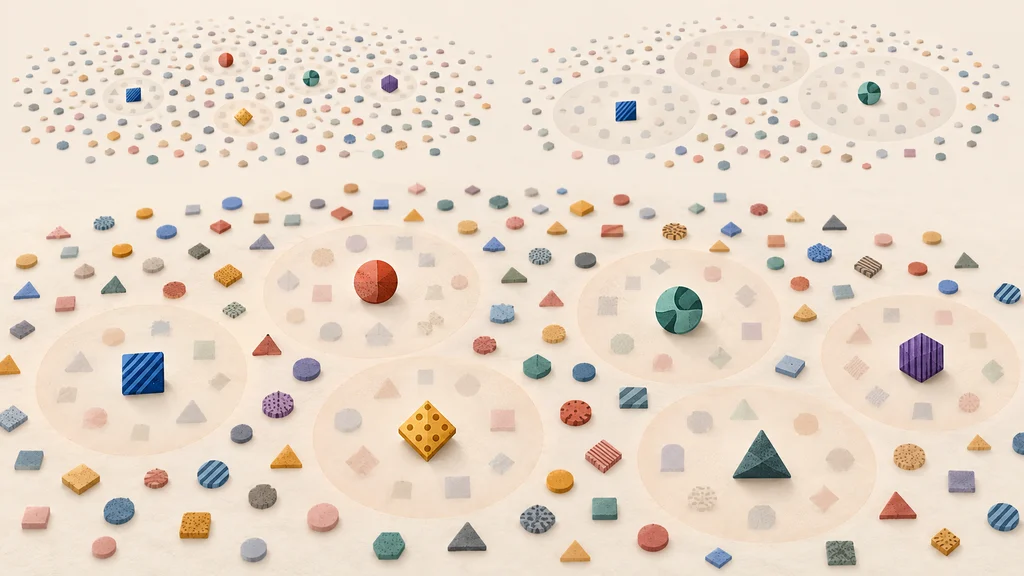
学習データ選択手法GISTは、データの多様性と有用性を両立する部分集合の選択に、数学的な品質保証を与える。Googleによると、両者を評価する目的関数で最適値の半分以上を得られるという。距離の下限を変えながら候補を作り、最も良い解を選ぶ。
データの間隔と情報の有用性を同時に扱う
Googleが開発した学習データ選択アルゴリズムGISTは、大きなデータ集合から、通常のモデル学習に使う部分集合を選ぶ。選択では、似たデータの重複を抑える多様性と、学習に役立つ情報を含む有用性の両方を扱う。
多様性の基準は、選んだデータ点同士の距離のうち、最も短い距離をできるだけ大きくするmax-min diversityである。有用性には、部分集合が含む重複しない情報を評価する単調劣モジュラ関数を用いる。離れた点を選ぶ基準と、役立つ情報を選ぶ基準を同じ選択処理へ組み込む。
近すぎるデータ点をグラフで結ぶ
GISTはまず、選択する点同士に必要な距離の下限を固定する。その下限より距離が短い2点を辺で結び、データ集合をグラフとして表す。
辺で結ばれた2点は、同じ部分集合へ入れるには近すぎる組み合わせとなる。互いに辺で結ばれない点を選べば、固定した距離の下限を満たすため、多様性の条件をグラフ上の選択条件として扱うことができる。
貪欲法で作った候補を距離しきい値ごとに比較する
このグラフで有用性の高い部分集合を探す処理には、2つの評価基準を扱う貪欲法を使う。選択済みの点に近すぎる点を避けながら、価値の高い点を順に選び、互いに辺で結ばれない点の集合を作る。
固定する距離が変われば、同時に選べる点の組み合わせも変わる。GISTは複数の距離しきい値でこの処理を繰り返し、得られた候補の中から最も良い解を選ぶ。
最適値の半分以上を保証する
Googleは、この選択処理によって、多様性と有用性のトレードオフを評価する目的関数で、最適値の半分以上の値を持つ部分集合を得る保証を証明したとしている。保証の対象はデータ選択問題の評価値であり、学習後のモデル精度を最適値の半分以上にするという意味ではない。
同じ最適化問題について、最適値の0.56倍を超える近似保証を達成することはNP困難だとも証明したとしている。得られた解の保証と、より強い保証を求める際の計算上の難しさが、それぞれ数値で示された。