AI
LLM推論で停止ワーカーの代替稼働を283秒から7.3秒に短縮
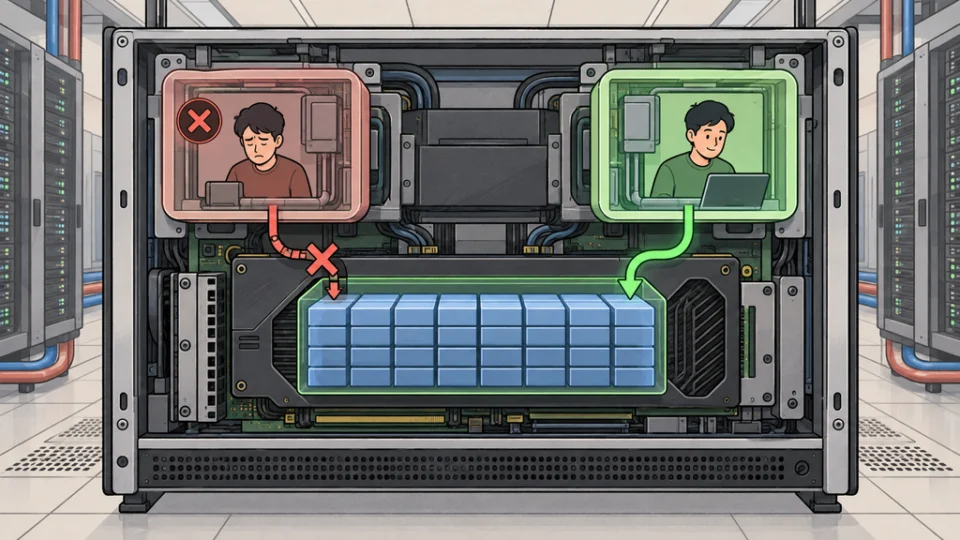
LLM推論エンジンの障害に備え、GPU上のモデル重みを共有する待機エンジンが事前に初期化される。NVIDIAの2ワーカー構成での測定では、1基の…
TOPIC
LLM推論エンジンの障害に備え、GPU上のモデル重みを共有する待機エンジンが事前に初期化される。NVIDIAの2ワーカー構成での測定では、1基の…
履歴を固定サイズへ圧縮し、必要な領域だけをブロック単位で参照する長文AIモデルが登場した。100万トークン条件の公開ベンチマークでは、Atten…
AIエージェントの作業記録を再生する評価で、推論基盤Vera Rubin NVL72がGB300 NVL72の最大30倍のメガワット当たり処理量…
自動運転のセンサー処理を、専用5nm ASICによる情報抽出と融合モデルの推論でつなぐ。Waymoが公開した車載計算基盤は、こうした専用処理にC…
ロボット制御用に追加学習した40億パラメータのAIモデルが、Jetson AGX Thor上で約2.13秒分の動作指令を約1.53秒で生成した。…
300億パラメーターのAIモデル「Muse Glimmer」を、モデル分割やCPUへの退避を使わず、単一GPU内で推論する構成が示された。NVI…
推論中の成功と失敗をスキルや洞察として抽出し、後続タスクで使える知識へ更新するテスト時学習が開発された。EvoLibは正解ラベルやモデル更新を使…