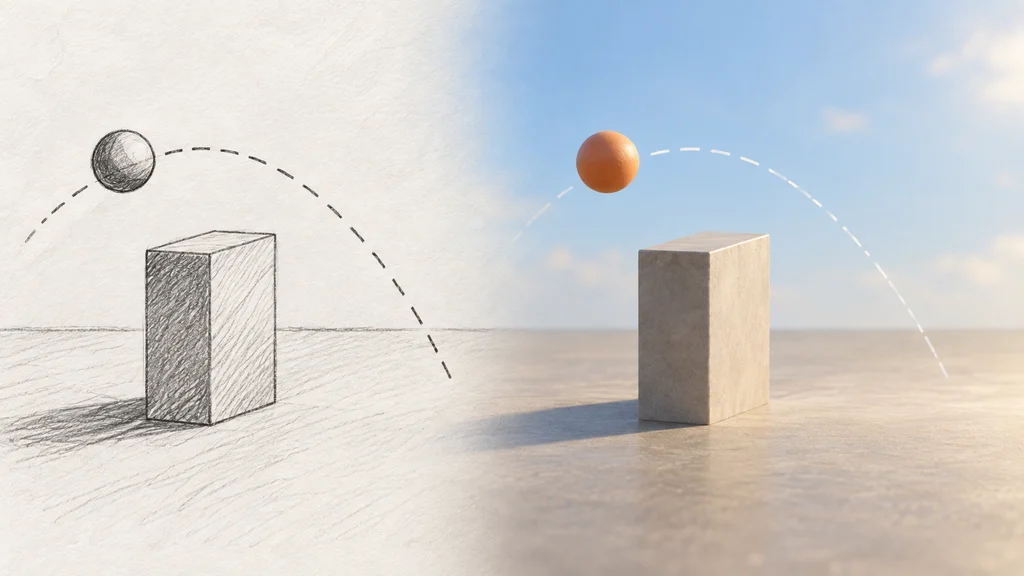
動画AIへ与える課題画像の見せ方を変えると、視覚推論の性能が改善する。画像を自動編集する手法VIPEは、複数の課題で効果を示した。
課題画像そのものを自動編集する
Google DeepMindが研究した視覚プロンプト調整手法VIPEは、モデルの性能改善を目的に課題画像を自動的に変更する。調整の対象は、モデルへ与える画像そのものだ。
球の着地点を問う場面を写真のように変える
具体例は、障害物を通過した球がどこへ着地するかを問う物理推論課題だ。画像編集モデルを呼び出すことで、抽象的なスケッチ状の場面を写真のような画像へ変換する。
画像の調整が複数の推論課題で効果を示す
Google DeepMindによると、VIPEは複数の課題で動画モデルの推論性能を改善した。改善の対象は、編集画像の見た目ではなく、その画像を使う動画モデルの推論性能である。
文章の調整や推論時の計算量増加と比較する
Google DeepMindは、動画モデルでは視覚プロンプトの調整が従来の文章によるプロンプト調整より効果的になる場合があるとしている。推論時に投入する計算量を増やすtest-time scalingとの比較でも、視覚プロンプトの調整がより効果的になる場合がある。