Technology
CUDA 13.4でWindows on Arm向けGPU開発が可能に
CUDA Toolkit 13.4は、Arm向けCUDAアプリケーション開発をWindowsへ拡張した。共有GPUの分割制御や、NVLink f…
TOPIC
CUDA Toolkit 13.4は、Arm向けCUDAアプリケーション開発をWindowsへ拡張した。共有GPUの分割制御や、NVLink f…
端末上のAI処理を担うCPUと、ニューラルグラフィックス向けの専用アクセラレーターを持つGPUが、一つのモバイル向け計算基盤に組み込まれた。処理…
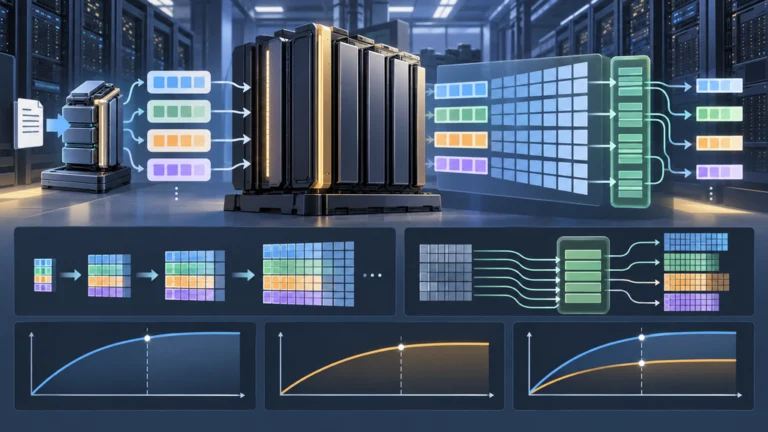
LLMの投機的デコードで先読みするトークン数について、NVIDIAはGPU上の行列演算とAttentionの処理特性に基づく選定指針を示した。候…
ROCmのマルチアーキテクチャ配布は、GPU固有カーネルを共通のホストコードから分離する。利用者は共通インデックスから、必要なGPU向けコードを…
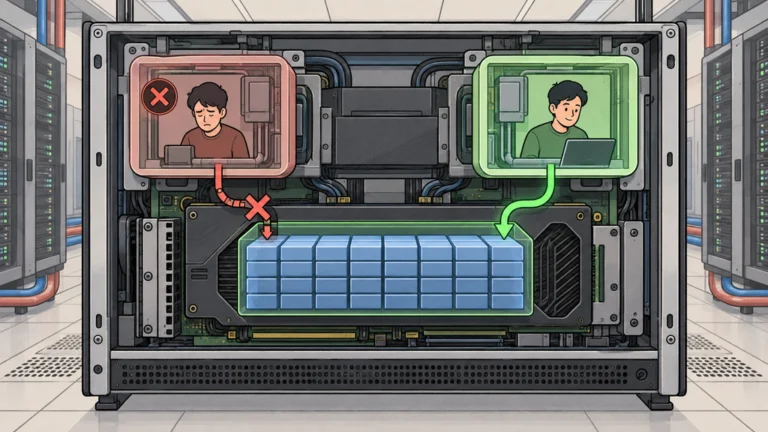
LLM推論エンジンの障害に備え、GPU上のモデル重みを共有する待機エンジンが事前に初期化される。NVIDIAの2ワーカー構成での測定では、1基の…
CUDA Python 1.0では、GPUのバッファーやストリームをPython向けライブラリで共有するための共通基盤と、公開APIの変更規則が…
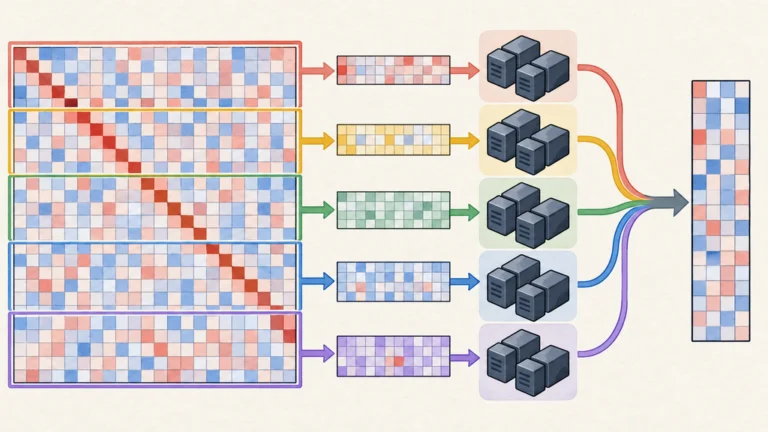
合成データから作った金融商品100万件の相関行列を、64基のGPUで約2分かけて因子分解したとNVIDIAは報告した。中間行列を省く計算式と行単…
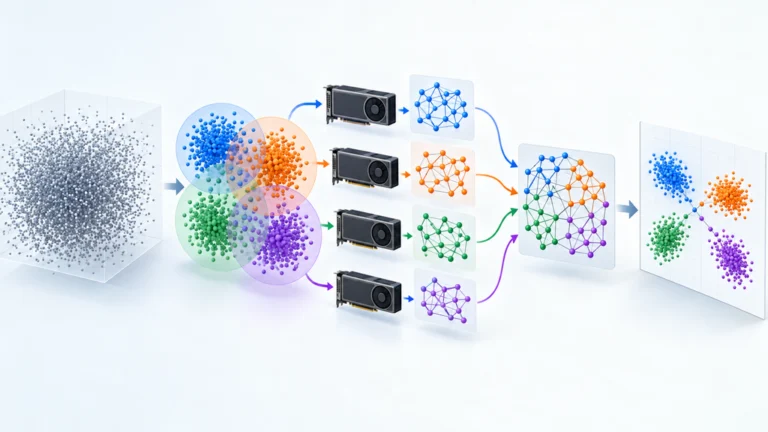
次元削減手法UMAPの学習で負荷の大きい近傍グラフ構築が、複数GPUへ分散された。NVIDIAの測定では、1億600万ベクトルの処理が8基のH1…