AI
分散負荷でGPUクラスタを検証し、障害ノードを絞り込む制御器
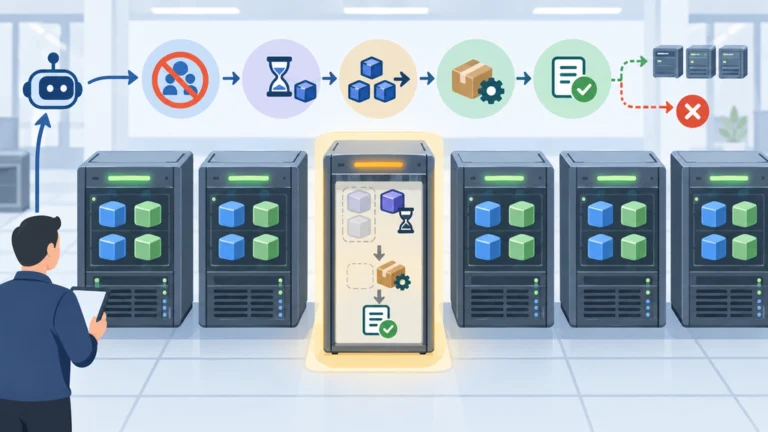
GPUクラスタの稼働前検証に、実際の分散ワークロードを使うKubernetes制御器が加わった。NVIDIA Cluster Readiness…
TOPIC
GPUクラスタの稼働前検証に、実際の分散ワークロードを使うKubernetes制御器が加わった。NVIDIA Cluster Readiness…
GPUクラスタのノードOSを変更する際、稼働中のジョブを考慮して適用順序を制御する管理ソフト「NodeWright」が公開された。Kuberne…
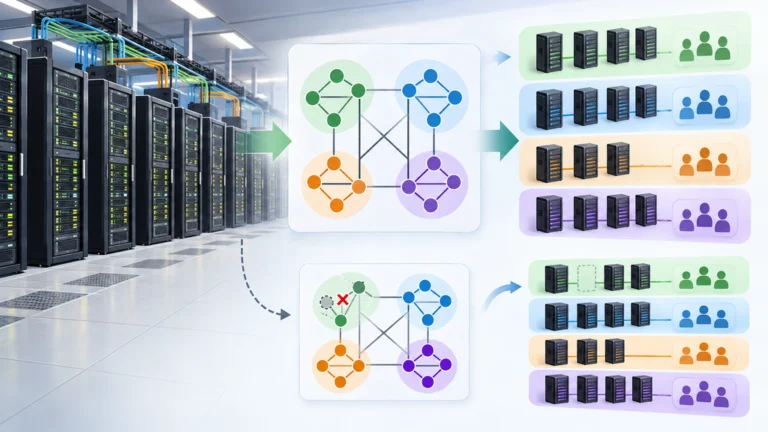
GPUクラスタの接続関係を検出し、AIジョブの配置に使う情報へ変換するオープンソースツール「NVIDIA Topograph」が公開された。クラ…
連合学習基盤NVIDIA FLARE 2.9がSlurmに対応した。常駐する連携処理とジョブの実行処理を分ける構成により、同じ連合学習に参加する…
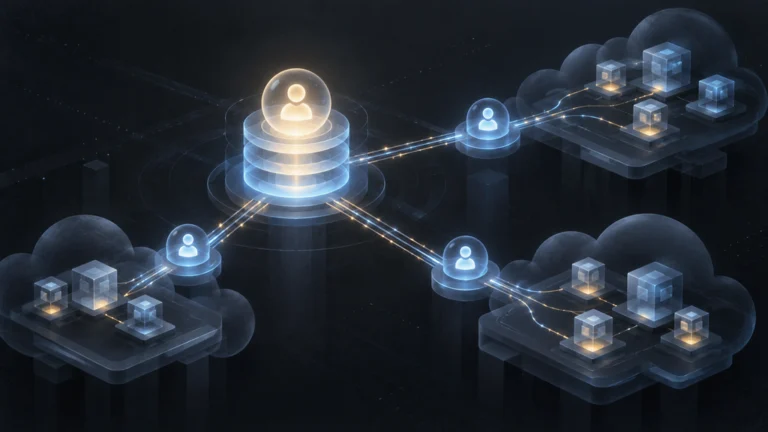
中央で保持する共通セッションを地域ゲートウェイが検証し、分散した実行環境へ信頼済みのユーザー情報を渡す。NVIDIAによると、この構成を採用した…
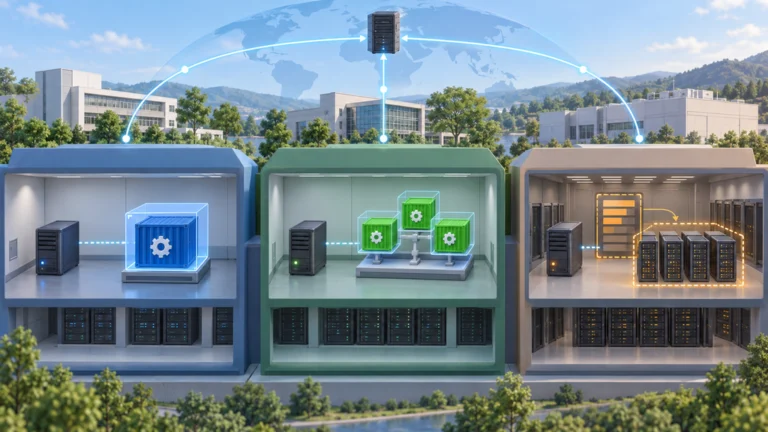
AIエージェントの実行環境を独立サービスへ分け、配備時と同じハーネス内で直接訓練できる共通基盤が公開された。隔離した実行領域をデータ収集、強化学…
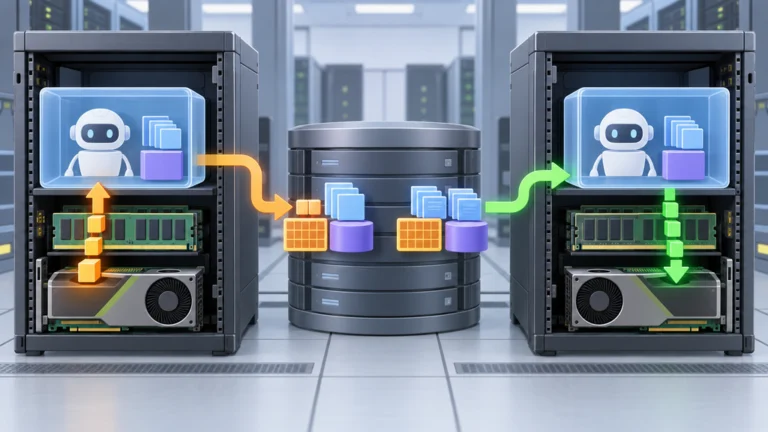
初期化済みのAI推論ワーカーを保存し、GPUとコンテナの状態を戻すことで、起動時の処理を省けるようにする。NVIDIAの初期試作「Dynamo …