AI
LLMのAttentionで参照データの共有を増やしても、入力処理時間はほぼ変わらず
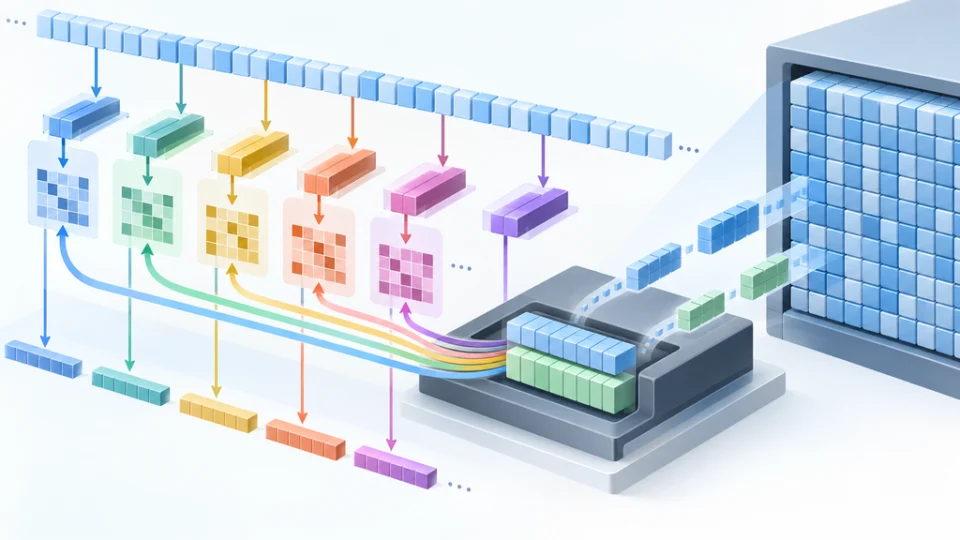
LLMのAttentionでKVヘッドを共有するクエリーヘッド数を増やしても、入力処理時間はほぼ変わらない。NVIDIAの測定では共有数を1から…
TOPIC
LLMのAttentionでKVヘッドを共有するクエリーヘッド数を増やしても、入力処理時間はほぼ変わらない。NVIDIAの測定では共有数を1から…
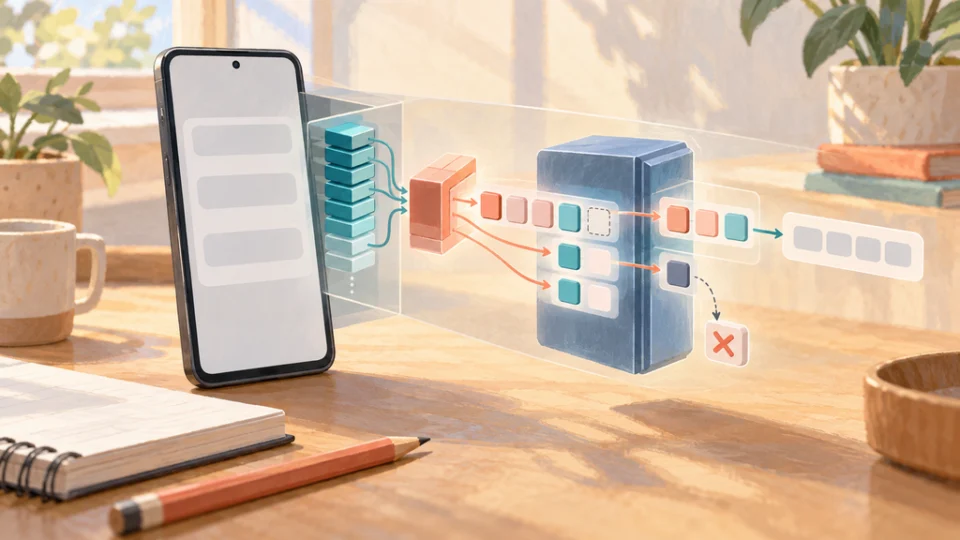
端末内AIモデルの重みを変えず、予測用の小型層だけを追加して文章生成を高速化する方式がPixel 9・10へ展開された。Gemini Nano …
AIエージェントの実行側が知る要求の優先度や出力長を、推論基盤の判断に渡せるようになった。NVIDIAは推論基盤Dynamoにagent_hin…