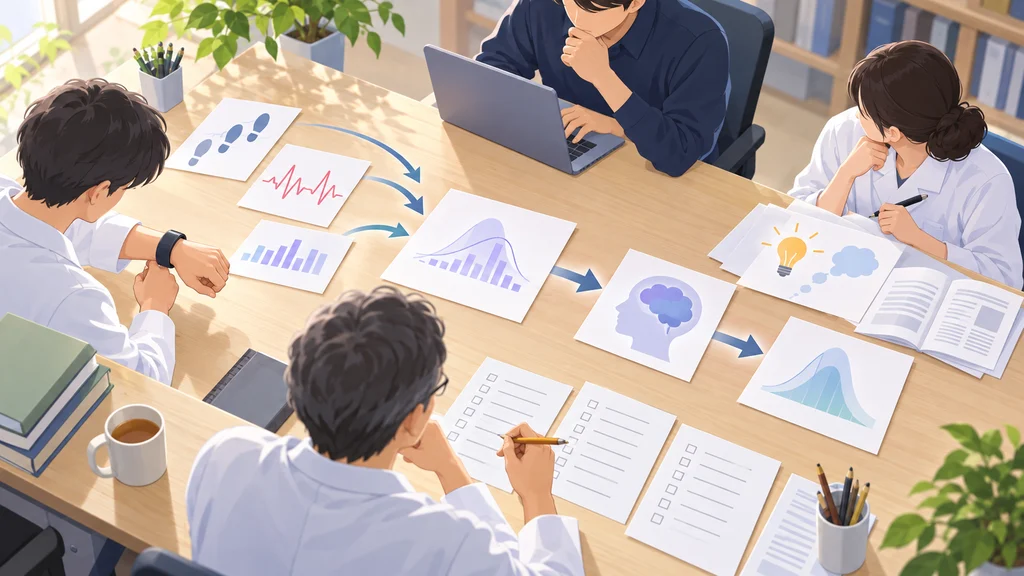
ウェアラブルデータから健康指標を探すAIが、仮説の生成と数値解析を分担し、候補を11項目で検査する。人間の監督下で動く研究用システムは、統計的な関連を調べ、専門家が検討する候補へ絞り込む。
研究指示を分解し、解析に入る前にデータを点検
Googleが開発した研究用AIシステムBiomarker Discovery Frameworkは、ウェアラブルセンサーのデータから、健康状態に関連する指標であるバイオマーカーの候補を探す。複数のAIエージェントが役割を分担し、人間の監督下で候補の優先順位を付ける。
処理の入口では、実行計画を統括するOrchestratorエージェントが自然言語の研究指示を分解し、専門エージェントを6段階の処理へ導く。データ理解を担当する処理は、データ構造、欠損、時間的構造、臨床評価項目を調べ、特徴量を作る際には予測対象のラベルを分離する。
生成AIの仮説をコードによる数値解析へ渡す
候補の仮説は、文献と仮説を担当するエージェントが既存の証拠を検索・確認して組み立てる。その証拠を基に、生理学的に妥当な特徴量や、複数の値を組み合わせる指標を提案する。
提案された特徴量は、統計解析と機械学習を担当するエージェントが決定論的コードで構築する。同じ処理で関連の推定、多重検定の調整、予測信号の評価を行い、仮説の形成と解釈を担う生成AIから数値計算を分ける。批判的検討を担うCriticエージェントが弱い仮定や未解決の問題を見つけると、必要に応じて追加の解析へ戻す。
11項目の検査から専門家レビュー用の草稿へ
解析で得た候補は、Criticと、候補を擁護する側のDefenderエージェントによる検査へ進む。目的変数の情報が特徴量へ漏れていないか、過学習や交絡に左右されないかに加え、測定概念の重なり、不安定性、生理学的な不自然さを点検する。
11項目の内部検査は、候補に条件付き、探索的、棄却、不安定などの報告用ラベルを付ける。続く報告作成では、担当エージェントが数値の主張を構造化された事実一覧と照合し、解析、図、文献、限界を専門家レビュー用の草稿へまとめる。
3コホートで候補を抽出し、複合指標も生成
Googleの評価では、精神健康領域のデータセットDWBとGLOBEM、代謝疾患領域のデータセットWEAR-MEへシステムを個別に適用した。計9,279件の参加者観測を解析し、精神健康に関する41件と代謝指標に関する25件のデジタルバイオマーカー候補を抽出した。
候補の生成は、入力に含まれる既存変数の選択だけにはとどまらない。代謝領域では、歩数を安静時心拍数で割った複合指標を構築し、インスリン抵抗性と関連する候補として取り上げた。
睡眠のばらつきに関連を検出、同一指標の再現とは区別
Googleの解析では、DWBで睡眠時間のばらつきと、うつ症状の評価尺度PHQ-8の重症度に関連があり、Spearmanの順位相関係数は0.252だった。GLOBEMでは入眠時刻のばらつきと評価尺度PHQ-4に探索的で弱い関連があり、相関係数は0.126だった。
この2つの結果は、睡眠に関係する概日リズムの不安定性という共通の概念を示唆する。ただし、対象集団、評価項目、特徴量の定義が異なり、同じ候補指標を再現した結果ではない。候補は因果関係を示す証拠ではなく、人間が検討する仮説として位置付けられる。