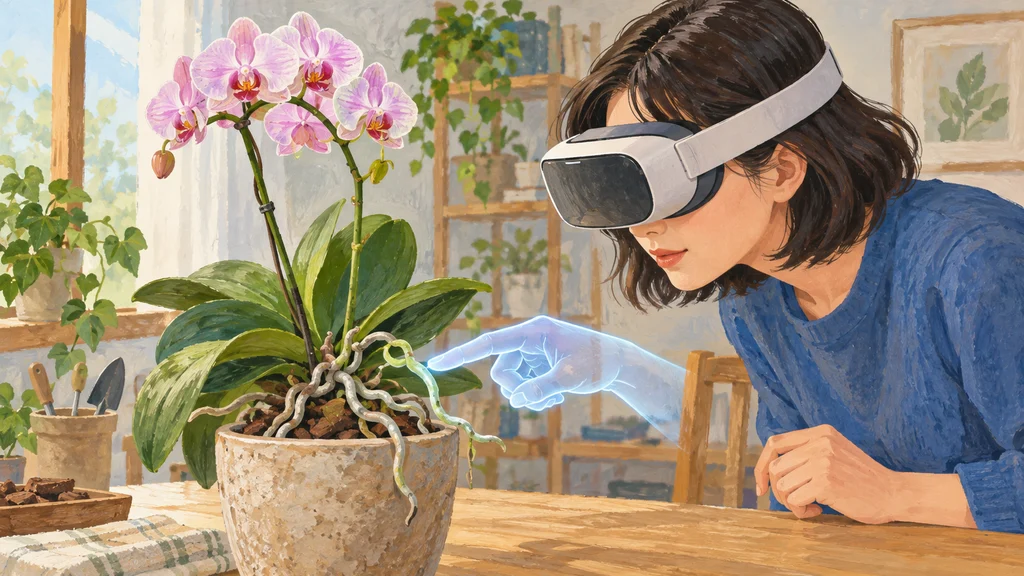
AIの言葉による案内に、実物の位置で動く仮想の手が加わった。XR研究試作AgentHandsは、登録した物体の3次元位置と発話のタイミングを結び付け、指差しや操作の実演を会話へ組み込む。
視線で指定した実物を3次元で登録する
Googleが開発したXR研究試作AgentHandsは、大規模言語モデルによる会話に、発話と同期する仮想の手を組み込む。案内の対象となる実物は、利用者の視線と周囲のシーン再構成を使って指定する。
指定した物体は、3次元の境界ボックス付きで登録され、会話エージェントが参照できるようになる。仮想の手の配置には、物体に固定した位置のほか、空中や利用者を基準とした位置も用意されている。
応答文の起動語が手の動作を呼び出す
手の動作は、対象を指し示すもの、形や行為を表すもの、社会的な合図や感情を伝えるものの3種類に分類される。大規模言語モデルは、この動作を指定するGestureEventsという身振りイベントを応答文に埋め込み、特定の起動語に結び付ける。
XRヘッドセット内のパーサーは、単語単位のタイムスタンプを受け取り、音声合成の再生と手のアニメーションを同期させる。この処理によって、言語モデルの応答は、音声と実空間に位置付けた手の動きによる案内になる。
植物の部位とノブの操作を手で示す
Googleによるランの手入れの実演では、仮想の手が株元へ移動した。そこで気根をなぞりながら、その役割を音声で説明した。
3Dプリンターの操作実演では、仮想の手がノブを回して押す手順を示した。その動作を使って、メニューの操作とファイルの選択を案内した。
同じ発話内容で物体の特定しやすさを比較
Googleは12人を対象に、各参加者が仮想の手を使う案内と音声だけの案内の両方を体験する比較実験を行った。両条件には研究者が用意した同じ発話内容を使い、仮想の手と同期した身振りの有無を変えた。
参加者は、案内が指す物体や方向を特定しやすいかを評価した。この評価は仮想の手を使う条件で有意に高く、Googleはp < 0.05の差を確認したとしている。