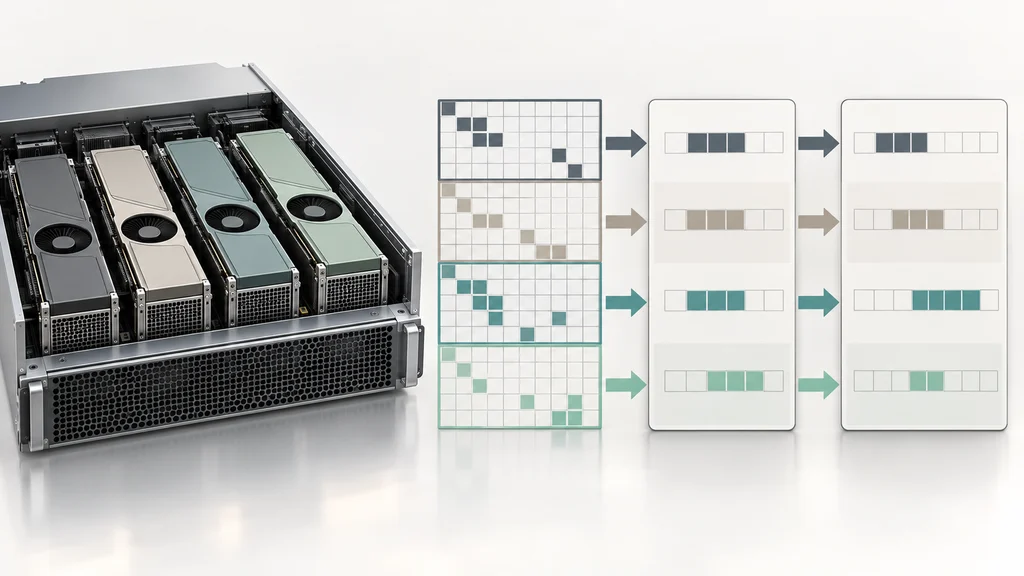
線形計画問題を複数GPUへ分散する新ソルバーmPDLPが、cuOptに加わった。連続する行列演算の依存関係を踏まえて計算を配置する。NVIDIAによると、非ゼロ要素数21億以下の問題で、GPUあたりのピークメモリー使用量が単一GPU版PDLPの最大6分の1になったという。
制約を満たす解を2つのベクトルで更新する
NVIDIAの最適化ソフトウェアcuOptに加わったmPDLPは、線形計画問題をNVLinkで接続した複数GPUへ分散する。線形計画では、線形の制約と変数の上下限を満たす範囲で、費用などを表す線形の目的関数を最適化する。
解を求めるPDLPは、勾配を使って反復的に計算を進める一次法だ。求める解を表す主変数のベクトルxと、制約に対応する双対変数のベクトルyを更新し、その更新を繰り返して解へ近づく。
行列演算の帯域を増やし、GPU間の待ち時間を抑える
反復の中心となるのは、ゼロの多い制約行列Aとその転置行列を使う疎行列・ベクトル積(SpMV)だ。yから次のxを計算し、そのxを使って次のyを計算する流れに、変数の範囲へ値を戻す射影や要素ごとの算術演算が組み合わさる。
SpMVの処理速度はメモリー帯域に制約されるため、複数GPUへの分散は利用できる帯域を増やす手段となる。一方で、GPU間通信の待ち時間や計算負荷の偏りが加わる。通信ライブラリNCCLは、NVLinkとGPU間接続を仲介するNVSwitchを利用して、GPU間の直接通信や集団通信を提供する。
連続する2つの演算を一緒に分割する
既存の分散方式D-PDLPは、制約行列を行方向と列方向に分け、各GPUへ部分行列を割り当てる。各GPUが計算した部分的な出力を通信で足し合わせ、元の行列に対応する出力を復元する方式で、SpMVをそれぞれ独立に扱う。
mPDLPの分割方式min-cut partitioningは、xとyを介して連続する2つのSpMVを一緒に考慮する。行列の疎な構造から、各出力の計算に必要な入力を捉え、強く結び付いた依存関係を可能な限り同じGPUに保つ。これにより、前の演算の出力を次の演算へ渡す際のGPU間通信を減らす。
GPUあたりのメモリー削減と大規模問題の高速化
NVIDIAの測定では、非ゼロ要素数を21億以下とした線形計画問題で、mPDLPのGPUあたりのピークメモリー使用量が単一GPU版PDLPの最大6分の1になった。この比較の対象は各GPUが必要とするメモリーであり、複数GPU全体の合計使用量ではない。
大規模ベンチマーク問題zib03には、1億400万を超える非ゼロ要素が含まれる。NVIDIAは、この問題を複数GPU上のmPDLPで解き、1年前と比べて解く速度が約10倍になったとしている。