サハラ以南アフリカの27言語を対象に、自然発話と音声合成向け録音を組み合わせた音声データセットWAXALが公開された。画像から発話を引き出す収集と、台本に沿った録音を使い分け、音声認識と音声合成の開発に必要なデータをそろえる。
認識用の自然発話と合成用の録音を分ける
Googleが公開した音声データセットWAXALは、サハラ以南アフリカの27言語を対象とする。音声を文字にする音声認識(ASR)用と、文字から音声を生成する音声合成(TTS)用の二つのデータセットを組み合わせている。
認識用のWAXAL-ASRには、書き起こし付きの自然発話が約1,846時間含まれる。合成用のWAXAL-TTSには、音韻的にバランスの取れた高品質な録音が565時間超含まれ、入力音声を扱うためのデータと出力音声を作るためのデータをそれぞれ提供する。
画像の説明から声調や言語の切り替えを捉える
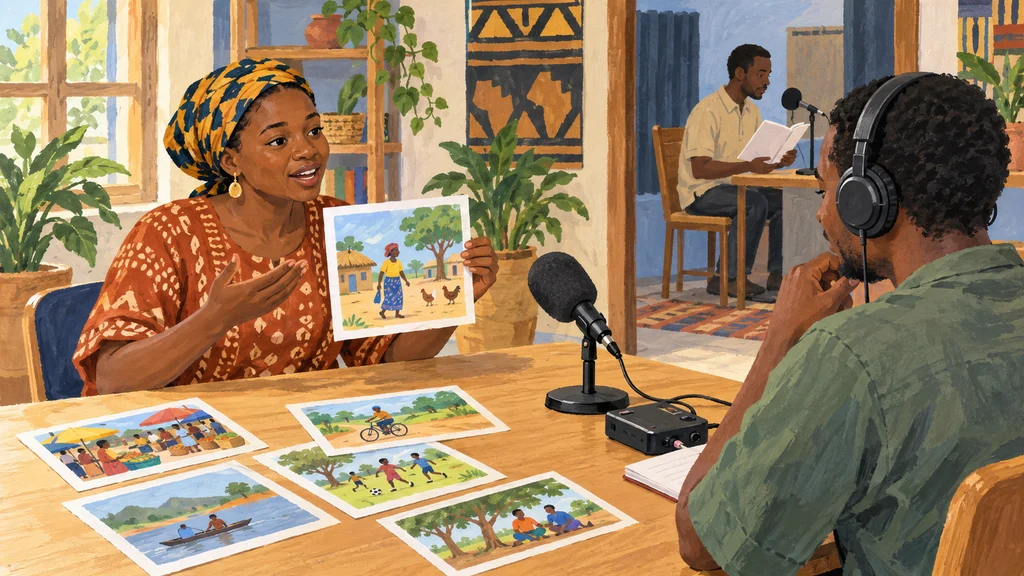
自然発話の収集では、参加者が台本を読み上げる代わりに、50以上の話題を扱う視覚刺激を母語で説明した。画像を発話のきっかけにすることで、読む文章をあらかじめ固定せずに音声を集めた。
Googleは、この方法で声調の違いや、発話中に言語を切り替えるコードスイッチングを含む言語的な変動を捉えたとしている。こうした変動を含む音声が、書き起こしとともに認識用データへ収められている。
台本と録音を対応付けて合成用データを作る
音声合成用の収集では、地域の参加者がペアを組み、1万〜2万語の台本を作成した。その台本を使い、読み手と録音担当を交代しながら音声を収録した。
参加者の一部は、録音環境を整えるためにプロジェクトの資金で専用の録音ボックスを製作した。収録した音声は分割して台本のテキストに対応付け、正確さと品質を確認して合成用データにした。
地域主導の収集データを所有権を保ったまま公開する
データ収集はアフリカの学術機関と地域組織が主導し、Googleの専門家が収集方法を支援した。共通の方法を使い、各パートナーが担当する言語のデータを集めた。
収集したデータの所有権は、参加したパートナーが保持する。この枠組みで集めた音声認識用・音声合成用データを、GoogleはCC-BY-4.0で公開した。