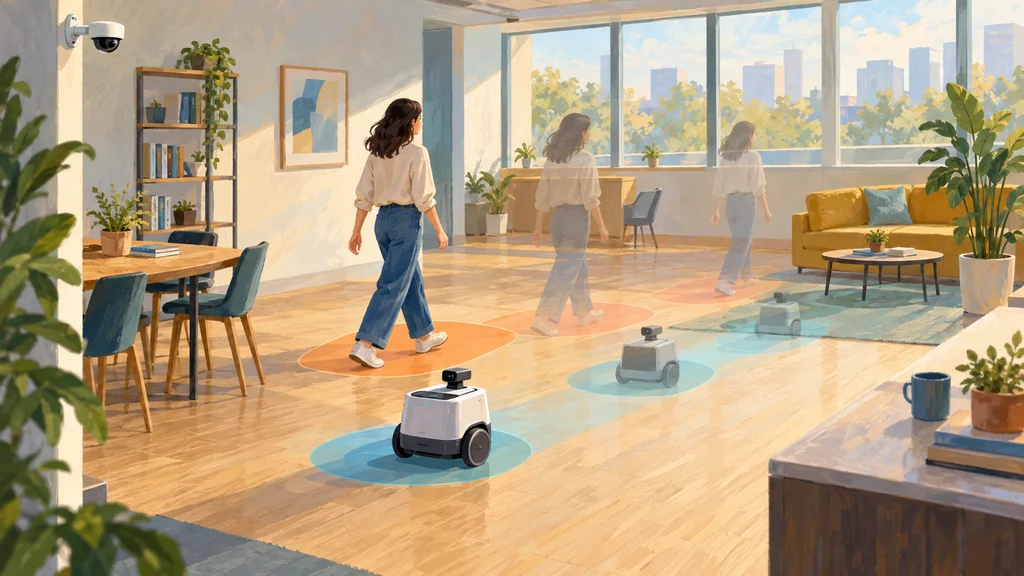
人やロボット、物体の関係の変化から、空間全体の未来を予測するAI技術を富士通が開発した。固定カメラとロボットカメラの情報を物体単位で統合し、周囲の状況把握を複数の行動主体の予測へつなぐ。
カメラの情報を物体単位で統合する
富士通が開発した空間World Model技術は、人とロボットの相互作用を予測するために、空間に設置したカメラとロボット搭載カメラの情報を組み合わせる。統合の単位には画素ではなく、人やロボットなどの物体を使う。
富士通によると、この方式はカメラごとの視野や歪みの違いの影響を抑えることができる。物体を単位に情報をまとめることで、人やロボットの移動に伴って変化する実空間をリアルタイムに把握するという。
物体間の関係の変化から次の行動を推定する
空間World Modelは、人・ロボット・物体の関係を3次元で表す3Dシーングラフを使う。このグラフの時系列データを学習し、空間内の相互作用を予測に取り込む。
予測処理は、人・ロボット・物体の相互作用から、複数の行動主体が次に起こす行動を推定する。その推定を通じて、対象空間が未来にどのような状態になるかを予測する仕組みだ。
目の前の環境から空間全体の協調計画へ
富士通は、従来のWorld Model技術では、ロボットの目の前の環境しかモデル化できず、空間内の人やロボットの状況変化を捉えにくかったと説明する。今回の技術は、予測の対象を空間全体に広げ、複数の行動主体の動きを扱う。
富士通が挙げる利用先は、自律ロボット同士の衝突回避や、複数ロボットの協調動作プランの生成だ。空間の状態を時間に沿って予測し、その予測を動作計画に利用できるとしている。
公開ベンチマークで行動意図の推定精度を評価
富士通は、カメラを通じて人の行動や行動目的を推定する公開ベンチマークJRDB-Socialで技術を評価した。その評価では、他者の行動意図の推定精度が自社の従来技術比で3倍に向上したとしている。