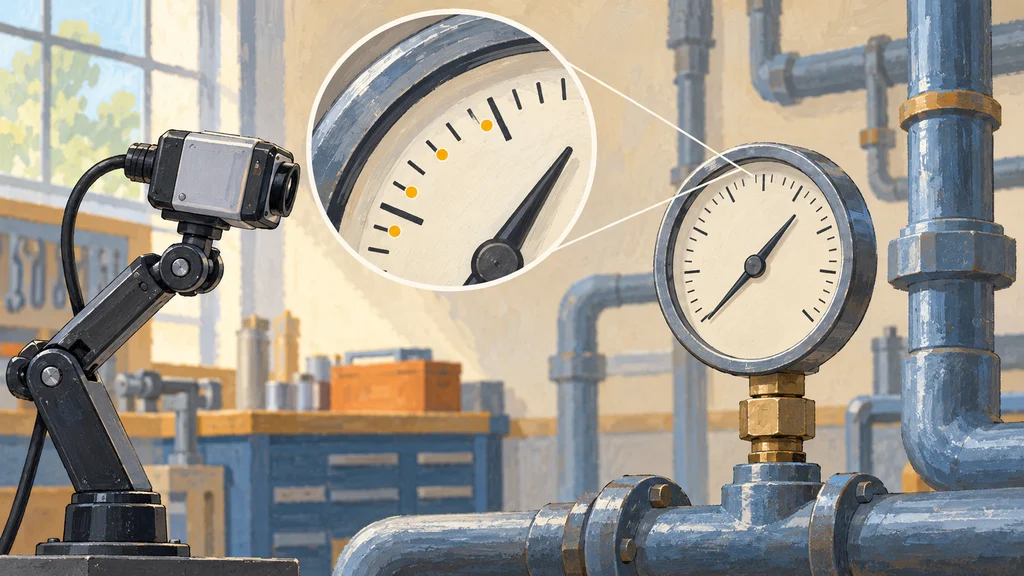
ロボット向け推論AIに、計器の画像を拡大して目盛りや液面を読み取る能力が加わった。Gemini Robotics-ER 1.6は、画像上の点の指定とコード実行を組み合わせて値を求める。Google DeepMindは開発者向けの提供も開始した。
拡大した計器画像から比率と間隔を求める
Google DeepMindによると、ロボット向け推論モデルGemini Robotics-ER 1.6は、円形圧力計、縦型液面計、デジタル表示を読み取ることができる。読み取りでは、まず画像を拡大して細部を捉え、画像上の点の指定とコード実行によって比率や間隔を推定する。その値に知識を適用し、意味を解釈する。
この処理を支えるagentic visionは、視覚的な推論とコード実行を組み合わせる機能で、前版のGemini Robotics-ER 1.5は対応していなかった。計器の解釈には、液面の見え方に影響する撮影角度や、表示された単位も関わる。
画像上の点を計数と数値推定につなぐ
画像上の点は、読み取り対象を示すだけでなく、物体を数えたり、数値を推定したりする中間段階にも使われる。Google DeepMindの工具画像の例では、更新モデルはハンマー2本、はさみ1本、刷毛1本、プライヤー6本を正しく識別した。
同じ画像で前版ははさみを見落とし、存在しない手押し車を指示した。更新モデルはその手押し車を指示せず、求められた対象が画像に存在するかどうかも識別した。
複数の視点から作業の完了を判定する
物体の位置や個数に加え、更新モデルは複数のカメラ視点を手掛かりに作業の状態を判断する。Google DeepMindが公開した例では、青いペンを黒いペン立てへ入れる作業について、複数の視点から完了を判定した。
作業完了の検出は、ロボットが次に取る行動を選ぶ判断に使われる。失敗した試行をやり直すか、計画の次段階へ進むかを決めるための入力となる。
上位推論から動作モデルや関数を呼び出す
Gemini Robotics-ER 1.6は、ロボットの上位推論を担うモデルとして、視覚・言語・動作モデルや利用者が定義した関数を呼び出すことができる。Google DeepMindは、この推論モデルをGemini APIと開発環境のGoogle AI Studioで開発者向けに提供した。