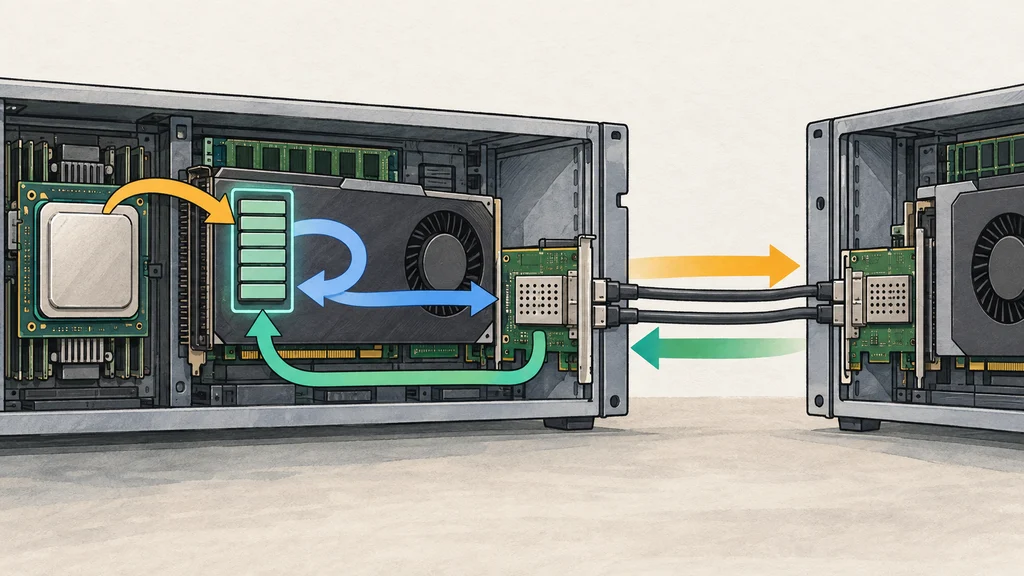
GPUから開始するネットワーク通信に、複数の通信ライブラリが共有する実装基盤が加わった。DOCA GPUNetIOはCPUで通信資源を準備し、CUDAカーネルから転送を進める。RDMA向けオープンソース版は、DOCA SDKと共通のGPU側インターフェースを持つ。
個別の通信実装を共有する基盤へ
NVIDIAによると、ネットワーク用ソフトウェア基盤のDOCA GPUNetIOは、GPUから通信を開始するGPUDirect Async Kernel-Initiated(GDA-KI)の共通基盤へ発展したという。GPU向け並列プログラミングインターフェースのNVSHMEMや、GPU間通信ライブラリのNCCLなどへ統合されている。
共通基盤への統合前は、各通信ライブラリがGDA-KI型のRDMA通信を個別に実装していた。独立していた通信経路をGPUNetIOで共有する構成では、各ライブラリが同じ実装を利用し、改良することができる。
CPUが準備した通信キューをGPUへ渡す
通信処理をGPUから開始する場合も、初期設定はCPUが担う。GPUNetIOを使うアプリケーションは、CPUでGPUとネットワークデバイスを初期化し、メモリーを確保して通信オブジェクトを作成する。
作成した通信キューの要素は、GPUNetIOのCPU側関数がGPUメモリー上の記述子へ書き出す。アプリケーションはその記述子のGPUアドレスをCUDAカーネルへ渡し、カーネル内の通信処理からキューを操作できるようにする。
CUDAスレッドが転送を開始し、完了を確認する
GPU側の処理は、渡された通信キューへ処理要求を登録するところから始まる。CUDAスレッドはWork Queue Entries(WQEs)と呼ぶ要求を登録し、ネットワークカードのレジスターへ書き込んで、新しい要求の実行を通知する。
ネットワークカードは要求を取得して実行し、完了キューへCompletion Queue Entries(CQEs)と呼ぶ完了情報を書き込む。GPUスレッドはこの情報を確認することができ、要求の登録から完了確認までをCUDAカーネル内で進められる。
GPUからネットワークカードへ直接通知できないシステムには、CPU支援モードがある。この構成でもGPUが要求を登録して完了情報を確認するが、実行通知はGPUから連絡を受けたCPUスレッドが代行する。
共通のGPU側APIでオープンソース版とSDKを接続
GPUNetIOのオープンソース版は、InfiniBandとroce上のRDMA通信を対象とし、GPU側では片側通信に対応する。DOCA SDK版はこの範囲に加え、RDMAの両側通信、Ethernet、DMAのGPU側データ処理にも対応する。
対応する機能の範囲は異なる一方、Verbsデータ処理用のCUDAヘッダーファイルは両版で同一である。GPU側の通信インターフェースを共有しながら、CPU側にはオープンソース実装とSDKを利用する経路が用意されている。
SDKを利用する経路は、環境変数DOCA_SDK_LIB_PATHに有効なSDKライブラリの場所を設定して選ぶ。オープンソース版はその設定に基づき、dlopenでDOCA SDKの関数を動的に読み込み、単独のオープンソース実装に代えて使用する。