Technology
CUDA Python 1.0、GPU資源を共有する共通基盤を整備
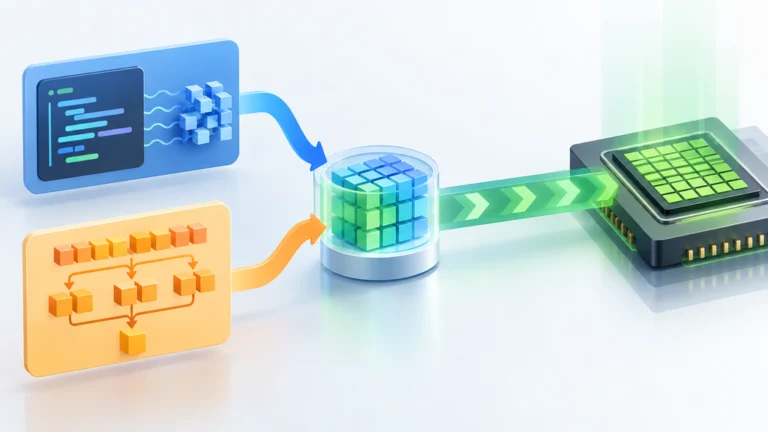
CUDA Python 1.0では、GPUのバッファーやストリームをPython向けライブラリで共有するための共通基盤と、公開APIの変更規則が…
CUDA Python 1.0では、GPUのバッファーやストリームをPython向けライブラリで共有するための共通基盤と、公開APIの変更規則が…
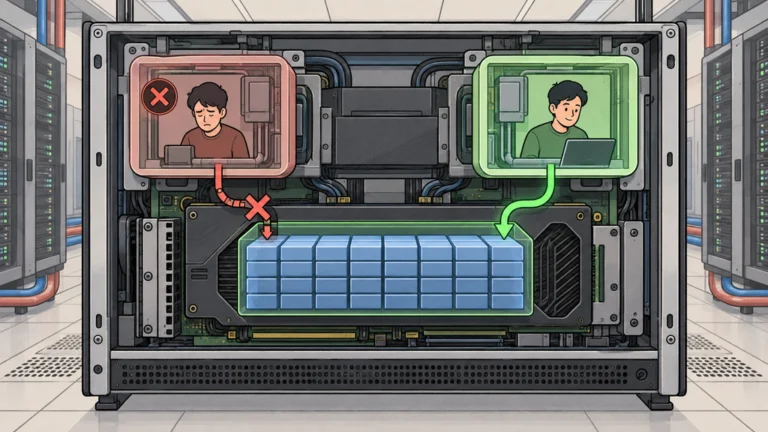
LLM推論エンジンの障害に備え、GPU上のモデル重みを共有する待機エンジンが事前に初期化される。NVIDIAの2ワーカー構成での測定では、1基の…
履歴を固定サイズへ圧縮し、必要な領域だけをブロック単位で参照する長文AIモデルが登場した。100万トークン条件の公開ベンチマークでは、Atten…
AIエージェントの作業記録を再生する評価で、推論基盤Vera Rubin NVL72がGB300 NVL72の最大30倍のメガワット当たり処理量…
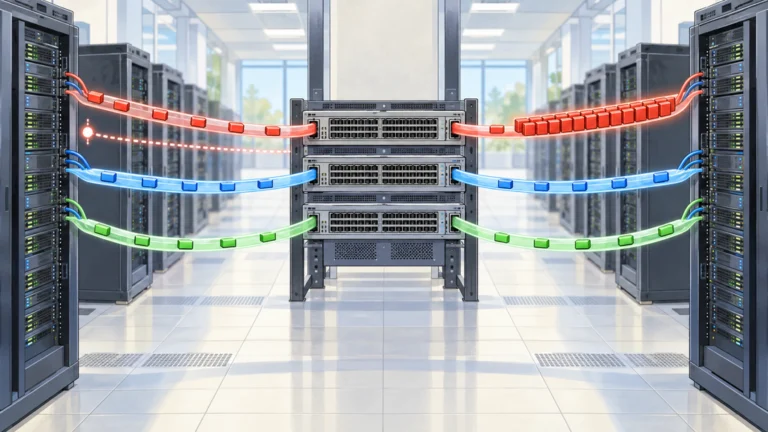
AI学習向けネットワーク「Spectrum-X Ethernet」は、混雑に応じたパケット経路の選択と送信速度の調整を組み合わせる。NVIDIA…
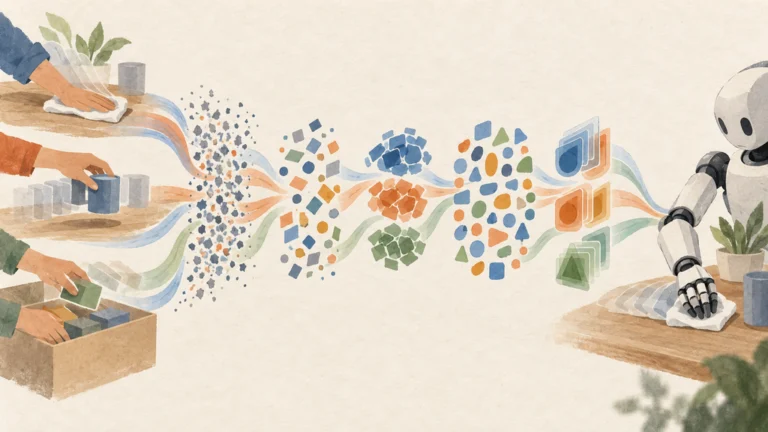
家庭や職場の実作業を撮影した動画が、品質検査、重複除去、再均衡化、説明付与を経てロボット学習用データへ変換されている。基盤は毎秒30分相当のアッ…
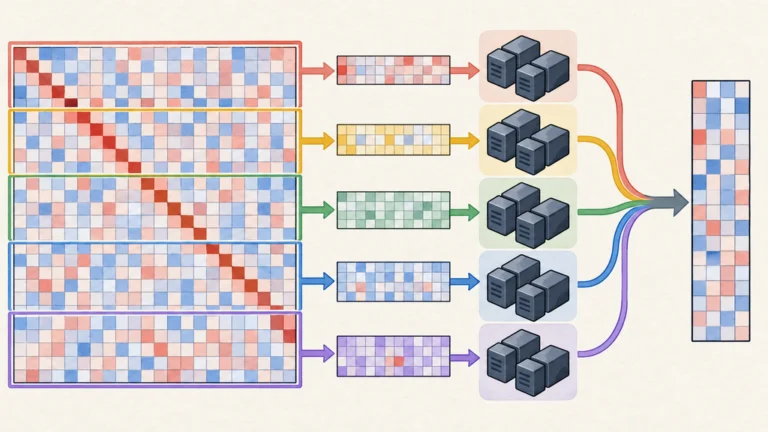
合成データから作った金融商品100万件の相関行列を、64基のGPUで約2分かけて因子分解したとNVIDIAは報告した。中間行列を省く計算式と行単…
AIエージェント用スキルの効果を、導入有無だけを変えた実タスクの対照実行で測定する仕組みが公開された。NVIDIAは300件超の検証済みスキルを…
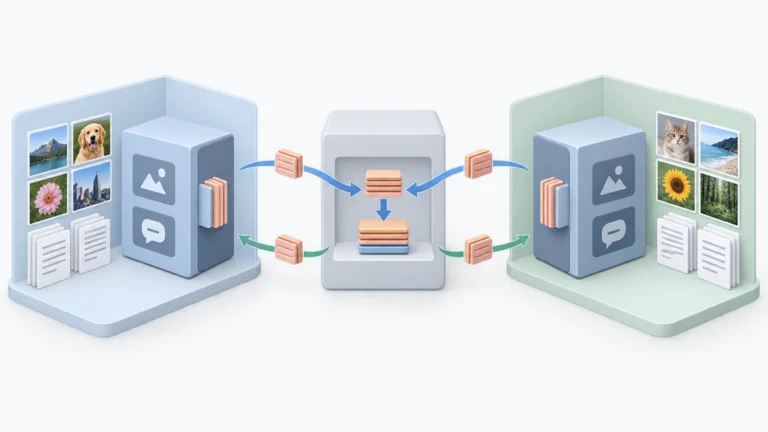
画像と言語を扱うAIの連合学習で、モデル全体ではなく軽量なアダプターだけを共有するFedUMMが、8クライアントの比較で各クライアント・各回の通…
内視鏡映像から器具を分割するアプリを、AI開発エージェントが既存モデルを再利用して構築した。NVIDIAは、段階的な測定と最適化により、描画処理…
AIが生成する材料シミュレーション用コードのAPI参照を、実行環境と専用ガイドの組み合わせで正確にできるか。NVIDIAの45件の評価では参照エ…
ロボット制御用に追加学習した40億パラメータのAIモデルが、Jetson AGX Thor上で約2.13秒分の動作指令を約1.53秒で生成した。…